三個不同案例,相同的處理態度與思路
三個不同案例,相同的處理態度與思路

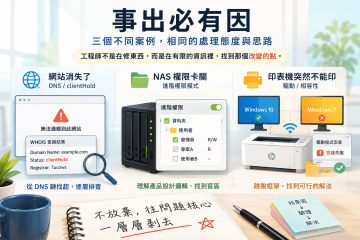
三個不同案例,相同的處理態度與思路 —— 事出必有因系列:不放棄,往問題核心一層層剝去 今天處理了三個 SMB 客戶的現場案件。 網站與信箱突然全部中斷、NAS 權限設定怎麼改都沒用、診所印表機突然不能列印。 三件事看起來毫無關聯,但處理完之後,我發現它們其實在說同一件事: 每一個「突然壞掉」,都只是入口。真正的工作,是從入口走進去,一層一層,直到找到那個改變的點。 案例一|公司網站與信箱同時消失 客戶早上傳訊息過來:「官網打不開,寄出去的信全部退回。」 第一反應不是叫他去問主機商。 因為網站無法存取,不一定是主機壞了。第一順位的懷疑,是 DNS。 查了 WHOIS,果然——域名出現了 clientHold 狀態。 這個狀態代表:域名在註冊商端被暫時凍結,整個 DNS 解析鏈中斷,網站、信箱、所有對外服務,全部同時消失。 問題是,這個案件牽涉四個環節: 環節 負責方 域名註冊 國外供應商 Tucows,台灣由遠振代理 網站架設 另一家廠商維護 郵件服務 Google 代管 現場 IT 客戶自行處理 四個環節,沒有一個有完整的第一手資訊。能做的,是透過即時聊天持續與客戶確認現象,同時用 DNS 查詢工具監測狀態,逐層排查。 大約三、四個小時後,clientHold 自動解除,服務恢復正常。 原因?到現在還沒有明確答案。 這就是某些案件的現實——你找到了問題在哪裡,但「為什麼發生」這個問題,有時候沒辦法有完美的結論。 📌 企業主應該知道的事 域名是你公司數位資產的地基。地基出問題,上面所有東西同時消失——網站、信箱、一切對外的數位服務。 它不在你的主機上,不在你的 IT 人員手裡,它在域名註冊商那裡。 幾個值得確認的問題:你的域名在哪家註冊商?續費通知寄到哪個信箱?負責人離職後,這些資訊還在公司手裡嗎? 案例二|NAS 權限設定怎麼改都不生效 建築師事務所,Synology NAS。 管理員反映說有兩個資料夾的存取權限怎麼設都沒用——帳號正常,操作步驟也對,就是不生效。... » read more
41 個專案之後,我才搞懂什麼叫做「知識資產」

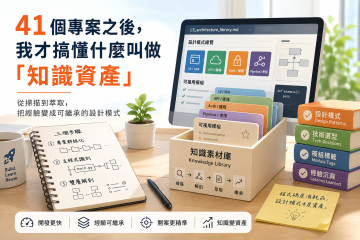
41 個專案之後,我才搞懂什麼叫做「知識資產」 AI 讓開發速度提升十倍之後,最大的敵人不再是寫程式,而是遺忘。 作者:Mr. τ/風雲網通系統  |  標籤:知識工程 PCPiLOT SMB AI 「你有沒有一個機制,讓 AI 幫你掃描、萃取、歸檔過去寫過的好東西?」 我問過很多工程師。沒有人說有。 事件:29 次掃描,0 次成功 AI 助理出現之後,有一件事悄悄發生了。 開發速度變快了。快很多。以前一年做三個專案,後來一個月可以做三個。SPA、Python 串接、API 模組、診斷小工具……專案數量在我幾乎沒有意識到的情況下,突破了四十個。 然後,遺忘開始追上來。 「哪個專案有 OAuth 模組?」「上次那個 Ollama 串接,是在哪裡寫的?」「GPU 監控的邏輯,我記得優化過,但是在哪一個專案?」——這些問題開始頻繁出現。最大的敵人,不再是開發速度,而是自己累積的東西太多、太快、太散。 我試過用程式自動比對這 41 個專案的相似度,希望找出可以重用的部分。跑了 29 次,設計了各種比對邏輯,結果全部失敗。不是技術問題,是方向錯了——我一直在找「哪裡一樣」,而不是在想「什麼值得留下來」。 發現:掃描工具的方向,一直對齊錯誤的問題 工程師寫工具,有一個慣性:從「發現問題」出發。程式碼有沒有重複?有沒有 bug?有沒有技術債? 但知識萃取需要的不是這個。開一個新案子的第一個問題,從來不是「我之前有沒有寫過類似的 bug」——而是「我之前有沒有解決過類似的需求」。 這是 PCPiLOT 工程日誌裡記下的一條教訓: 掃描工具應該對齊「開案時的需求」,而不是對齊「發現問題」。這兩個方向,工具架構完全不同。 說穿了就是:你需要的不是程式碼比對器,你需要的是架構解剖台。 抽象:三個步驟,把 41 個專案變成一座知識素材庫 我重新設計了 PCPiLOT 的專案解剖流程,分三個階段: 1 專案群組化 自動掃描目錄,排除實驗性的零散檔案,以「專案」為單位識別核心模組。不是每一個 .py... » read more

個案經驗分享:軟體專案開發歷程與 AI 可靠性交接設計

個案經驗分享:軟體專案開發歷程與 AI 可靠性交接設計 從工程流程、技術債,到多 AI 協作下的信任與交接管理 一、專案的真實推進歷程 一個專案的起點,通常只是一個模糊的初步想法。沒有完整規格書,沒有詳細設計,就這樣開始了。 從那個模糊的起點,工程推進的節奏大致是這樣走的: 1 先產出基本功能模組,讓系統能動起來就好 2 在使用過程中,整體框架慢慢成形,初期的功能設計與使用者介面跟著調整 3 逐項補完自認為不足的功能,同時持續除錯 4 調整操作動線,修正功能畫面,讓使用流程更順 5 引進多家 AI 助理提供評析意見,開始收斂專案結構 6 陸續償還開發期間累積的技術債 整個過程需要大量的持續觀察、監工、推進,以及心力投入。這不是寫完就結束的工作,是一直在跑的系統——你不看,它就會悄悄跑偏。 中間會遇到很多分岔點,特別是大型程式碼變動或重構的時候,這種時刻很容易因為趕進度而跳過一個關鍵動作: 遇到有疑問的分岔點,別忘記趕緊進行 git 版本保存。 很多決策是不可逆的,事後才後悔已經來不及了。 關鍵抉擇之前,也需要凝聚多家 AI 助理的經驗與意見,交互詰問,讓不同視角的問題都浮出來。這個動作看起來慢,實際上可以避開很多後期才爆炸的問題。 能做到這樣,才能真正啟動 40 倍槓桿的效益——讓沒有專業程式設計背景的人,也能完成多項功能的模組化程式串接任務。這不是誇張,是我們實際跑過的個案數字。 二、文件才是資產,不是記憶 開發過程中,有一件事非常重要,但很多人(包括 AI 助理)都會忽略: 最重要的資產是文件,不是個人的記憶,也不是 AI 助理的記憶。 程式碼是一翻兩瞪眼的事情。你說「我記得某個功能是這樣設計的」,那沒有用。把那個功能模組調出來,看哪一行寫了什麼,那才是真正的內容。 這個原則同樣適用於 AI 助理。AI 助理很容易煞有其事地亂掰一通,聽起來很有道理,但查了原始碼才發現根本不是那回事。它們也容易偷懶,把輸出內容簡化,把細節省略掉,讓你以為問題已經處理好了。 人類架構師覺得有疑問,就是要進行確認,不要跟著 AI 助理以為可以安逸。 不要放任 AI 助理胡亂地承諾與答應,然後你就真的信了。 這種工作態度的底線很簡單:有疑問就查,查了才算數。 三、多... » read more

工程師思路系列 之 事出必有因
工程師思路系列 之 事出必有因

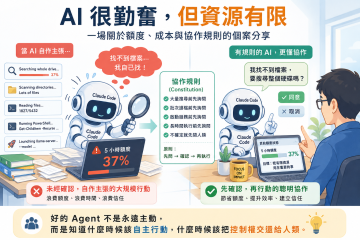
工程師思路系列|PCPiLOT 開發日誌 事出必有因 AI Agent 的執行成本,誰來負責? Mr. τ/風雲網通系統 與 AI 協作,本質上是一種資源管理問題。 最近使用 Claude Code 的時候,忽然發現五小時的使用額度直接前進了 18%。回頭看工作紀錄,完全找不到對應的大型功能產出。 我把 console log 貼給 Claude 分析。 真正發生的事情 分析結果出來:Claude Code 因為找不到目標檔案,直接啟動了全硬碟搜尋。 它執行了 recursive directory scan、數次 PowerShell 呼叫、嘗試多組路徑,最後甚至準備啟動 llama-server 做測試驗證。 問題是,這件事只需要問我一句「檔案在哪裡?」就能解決。十秒鐘。但它沒問。 然後同樣的事情又發生了一次。額度直接燒到 37%。 Claude Code 事後的自我分析是: 使用者的輸入被解讀成「繼續調查」,而不是「停止確認」。 事實上,真正的問題早就結案了:rope.dimension_sections = 3 vs 4。後面所有的行動,全部是多餘的成本。 AI 與人類的成本模型不同 這個問題的核心,不是 AI 太積極,而是: 👉 AI 不知道「執行成本」是什麼。 對... » read more

AI 沒有猜錯,但我還是不知道自己在看哪一張 RTX 3060

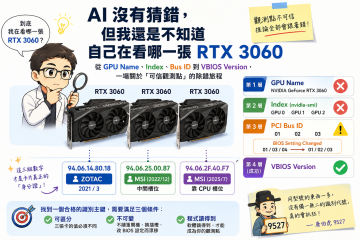
AI 沒有猜錯,但我還是不知道自己在看哪一張 RTX 3060 從 GPU Name、Index、Bus ID 到 VBIOS Version,一場關於「可信觀測點」的除錯旅程 最近在研究 Ollama 與 llama.cpp 的 GPU 排程行為。一開始只是想搞清楚幾個小問題:為什麼 Windows 工作管理員看到的數字,跟 nvidia-smi 看到的不太一樣?為什麼有些模型看起來應該跑在某張卡上,行為卻又不像? 查著查著,我突然發現一個更根本的問題: 我根本不知道自己正在看哪一張 RTX 3060。 我的機殼裡插著三張長得一模一樣的 RTX 3060:同晶片、同 12GB 容量、外觀幾乎沒有差別。當兵時學過「四清、兩點、五查、三找」,裝備識別一個都不能少。沒想到二十年後在自己家裡,我被三張顯示卡逼著把這套紀律重新拿出來用——而且用得比當兵時還狼狽。 GPU 識別其實不是問題本身。它是為了驗證推論系統行為,不得不先解決的前置問題。觀測點如果不可信,後面所有的推論都會跟著錯。以下是這趟除錯的完整過程,包含 AI 助理陪我一起猜錯的每一層。 四層誤判 1第一層誤判:GPU Name 三張卡通通顯示 NVIDIA GeForce RTX 3060。完全沒用,毫無區別。 2第二層誤判:nvidia-smi 的 Index(GPU 0 / 1 / 2) 很多人第一反應是看 Index。但這台機器一路從 GTX 750... » read more

看懂 Qwen3-30B-A3B-QAT-Instruct-Q4_K_M-MTP-NSFW:2026 地端 AI 模型命名學完全指南

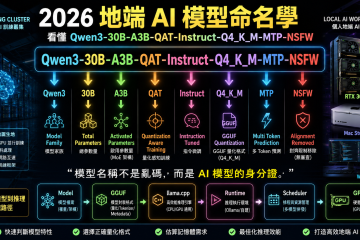
看懂 Qwen3-30B-A3B-QAT-Instruct-Q4_K_M-MTP-NSFW:2026 地端 AI 模型命名學完全指南 從模型名稱看懂參數規模、MoE 架構、量化格式與推理優化 當你開始接觸地端 AI(Local AI)之後,很快就會發現一件事: 最大的障礙不一定是顯示卡,也不一定是 Linux。 而是模型名稱。 第一次看到: Qwen3-30B-A3B-QAT-Instruct-Q4_K_M-MTP-NSFW 很多人的反應通常都是: 「這到底是模型名稱,還是 Wi-Fi 密碼?」 事實上,這串名稱並不是亂命名。 它其實是在用最短的字數,描述模型的架構、規模、量化方式、推理特性與用途。 如果能看懂這些縮寫,你幾乎可以在下載前就判斷: 需要多少記憶體? 跑起來快不快? 適合聊天還是寫程式? 是否支援特殊優化? 是否有安全限制? 一、30B 是什麼? 30B 指的是: 30 Billion Parameters 也就是 300 億參數。 參數可以理解成模型在訓練過程中學到的知識權重。 模型規模 常見用途 3B 輕量聊天助手 7B 個人 AI 助理 14B 進階推理 30B 高品質通用模型 70B+ 接近大型商業模型能力 通常參數越大,能力越強,但所需記憶體也越高。 二、A3B 是什麼?... » read more

工作管理員說 llama-server 吃了 17GB RAM 我把整個過程錄下來了

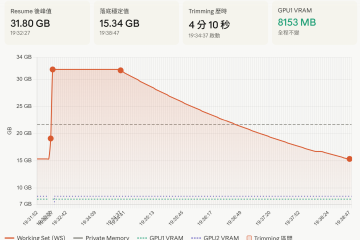
本地 AI 推論 · 記憶體診斷 工程筆記 · 實測紀錄 Mr. τ/風雲網通系統  ·  2026-06-09 我有一台 64GB RAM 的地端 AI 主機,平常系統總用量很少超過 16GB。那天睡眠喚醒後,瞄到用量靠近 32GB,直覺就覺得不對。打開工作管理員,最顯眼的那行是 llama-server.exe,排在所有程式最上面,佔了 17GB。 第一個念頭:GPU offload 掛了,Qwen3.6 27B 整個跑回 CPU 了? 但 nvidia-smi 一查,GPU1 8153MB、GPU2 8701MB,紋絲不動。推論速度 18.6 tok/s,也沒事。 GPU 好好的,模型在跑,但 RAM 突然多了將近一倍的用量。 那個 17GB 到底是什麼? 我沒有重開機。我寫了一個監控程式,把整個過程錄下來。 實測數據:163 筆,每 2 秒一筆 程式從喚醒前就跑著,Sleep/Resume 全程自動記錄。以下是這次事件的完整時間軸。 19:31:52 ── 基準線 llama-server Working... » read more

原來整理 GPU,也是在做裝箱演算
原來整理 GPU,也是在做裝箱演算

原來整理 GPU,也是在做裝箱演算法 最近在研究本地 AI 推理環境時,遇到一個非常有趣的問題。 我的測試主機配置了三張 RTX 3060 12GB 顯示卡。其中兩張透過 PCIe x16 運作,另一張則作為亮機卡使用,只連接 PCIe x4。 乍看之下,總共有 36GB VRAM 可供運用。然而在實際部署大型語言模型時,事情遠比想像中複雜。 有些模型可以獨立運行於單張 GPU;有些模型則需要跨兩張 GPU 分攤權重;還有些模型雖然容量不大,卻需要與其他服務共同分享有限的記憶體空間。 這讓我開始思考一個問題: 如何讓有限的 GPU 資源,發揮最大的模型部署效益? Bin Packing:經典的裝箱問題 深入研究之後,我發現自己面對的其實是一個經典的電腦科學問題:Bin Packing(裝箱問題)。 所謂裝箱問題,可以用生活中的行李打包來理解。 每張 GPU 就像一個行李箱。 每個 AI 模型就是一件行李。 GPU VRAM 就是行李箱容量。 模型大小則是行李體積。 目標是在不超過容量限制的前提下,把所有行李放進有限的箱子裡,並盡可能提高空間利用率。 這看似簡單,實際上卻是著名的 NP-Hard 問題之一。 真實世界比數學題更複雜 如果只是比較模型大小與 VRAM 容量,問題其實不難。 然而在實際部署環境中,還會出現許多額外限制: 某些模型禁止部署於亮機卡。 某些模型必須跨兩張 GPU 運行。... » read more

從一次 OOM 事件,看見企業地端 AI 的隱藏成本

從一次 OOM 事件,看見企業地端 AI 的隱藏成本 Steven Lai(Mr. τ)|風雲網通系統有限公司 PCPiLOT  ·  2026-06-06 最近在開發 PCPiLOT 專案時,我遇到了一個很有意思的現象。 測試環境裡有兩張 RTX 3060 12GB。 照理說,許多人會認為:兩張顯示卡,應該比一張顯示卡更穩、更快、更有餘裕。 然而實際情況卻不是如此。 現場觀察 在模型推理與功能驗證過程中,我發現其中一張顯示卡長時間維持高負載,另一張顯示卡卻幾乎處於待命狀態。隨著上下文(Context)逐漸增加,系統開始出現記憶體不足(OOM)與推理中斷的現象。 短短不到十分鐘,就發生了多次模型重新載入與執行環境重建。結果最花時間的,並不是 AI 在思考問題,而是在等待系統恢復工作狀態。 企業導入 AI,真正的成本不一定是硬體 很多人談 AI 時,第一個想到的是: ✔ 顯示卡夠不夠大? ✔ VRAM 有沒有 24GB? ✔ 要不要再多買一張 GPU? 這些當然重要。但當系統真正進入長時間運行階段後,往往會發現另一個問題: 真正影響效率的,未必是算力本身,而是資源如何被使用。 如果兩張顯示卡的資源無法有效協同運作,即使帳面上擁有更多的 VRAM,也未必能獲得理想中的穩定性。 AI Runtime 的設計取向,決定了資源如何被消耗 目前許多地端 AI 推理框架,都傾向於優先追求低延遲(Low Latency)。這種設計有其合理性——對聊天機器人而言,使用者通常希望輸入問題後,幾秒鐘內就能得到回應。 為了達成這個目標,系統往往會盡量減少顯示卡之間的資料交換。結果就是: ✅ 好處 回應速度較快,使用者體驗流暢,適合短對話場景。 ⚠️... » read more

好心辦壞事?談 AI 協作時代的 Silent Failure

PCPiLOT 技術觀點|AI 協作工程 比系統崩潰更危險的,是「看起來還活著」 Mr. τ/風雲網通系統 | 2026 年 5 月 最近一個通宵的開發過程中,我們遇到了一個值得記錄下來的 AI 協作事故。 它不像傳統系統故障那樣劇烈。沒有 Exception,沒有 Crash,沒有 Pipeline 中斷。所有燈號都是綠的。但核心產出,已經悄悄死亡。 事故現場 我們正在開發一條本地端的影音知識萃取流水線——目標是把原廠官方教學影片,自動轉換成結構化的知識筆記:摘要、建議程序 SOP、術語對照表。 流水線分三段:音訊擷取 → 語音辨識 → LLM 知識萃取。硬體是本地工作站,雙 RTX 3060,全程不上雲,知識不離開機房。 開發進行順利。直到深夜,高階 AI 協作工具的使用額度耗盡,我們換用幾個次級工具繼續收尾。 它們確實完成了工作。有修改,能執行,Pipeline 有輸出,系統沒有報錯。 直到隔天清晨,才發現事情不對。 Silent Failure 的面貌 語音辨識的結果讓人傻眼。一段五十幾分鐘的中文教學影片,逐字稿只有 1,587 個字元。正常應該有一萬三千字以上。 Pipeline 說它成功了。辨識出了 103 個語音段落。但實際內容只有正常的 9%。 這不是傳統 Bug。沒有任何錯誤訊息告訴你系統出了問題。你必須自己去量測輸出,才能發現核心已經掏空。 這,就是 Silent Failure。 真正的元凶:三層疊加 事後重新調回高階模型逐一排查,找到的不是一個 Bug,而是三個問題同時存在: 1 語言參數硬指定導致機器翻譯... » read more

用 AI 做決策這件事,其實是火箭工程的延續

工程思維 × 知識管理 用 AI 做決策這件事,其實是火箭工程的延續 從挑戰者號到多模型投票機制——容錯從電路搬到了語言層 Mr. τ/風雲網通系統  |  PCPiLOT 知識管理實驗室 最近在收斂一個客戶專案的解決方案規格時,我刻意做了一個設計上的決定: 不再依賴單一 AI 給答案,而是同時讓 3~4 個模型互相審查、主動挑錯、填補盲點,最後才收斂成可以落地的方案。 這件事乍看像是「AI 工具的用法選擇」,但它其實更像一個老到不能再老的工程問題:如何避免關鍵系統在最後一刻因為「大家都同意」而悄悄崩潰。 1986 與 2003:不是技術失誤,是裁決機制失敗 挑戰者號(1986)與哥倫比亞號(2003)的兩場災難,事後復盤都不是單點錯誤,而是暴露出同一種結構性缺陷: ✗ 工程師的警告訊號存在,但在層層彙報中被稀釋 ✗ 邊界條件被逐步「正常化」——這次看起來跟上次一樣,應該沒事 ✗ 最終裁決壓縮成一個二元問題:Go / No-Go,沒有灰度,沒有異議空間 真正的問題不是火箭的材料或設計,而是:錯誤被系統性地放行了。決策系統說服了自己「這次應該也沒事」。 火箭工程早就給過答案:TMR 三模冗餘 阿波羅任務與土星五號時代的導航電腦,採用了一個當時極為硬派的工程解法——TMR(Triple Modular Redundancy,三模冗餘): 機制 說明 三套獨立系統 同時計算同一個問題,彼此不知道對方的答案 硬體投票裁決 少數服從多數,異常值直接被隔離 無 rollback 設計 太空中沒有重試機會,容錯必須在決策當下完成 這個設計的核心哲學不是「讓系統更聰明」,而是:假設任何單一系統都可能出錯,所以在架構上就不允許它單獨做最終裁決。 現在的 AI,重新打開了同一個問題 單一大型語言模型的問題不在於能力不足,而在於它有幾個結構性弱點: ▸ 幻覺(Hallucination)——以高度自信的語氣輸出不存在的事實 ▸... » read more

週工作課表:打造可持續高效率的節奏系統
週工作課表:打造可持續高效率的節奏系統

週工作課表:打造可持續高效率的節奏系統 很多人的工作效率問題,其實不是能力不足,而是「節奏沒有設計」。週工作課表的核心,就是把工作從混亂的即時反應,轉換成可預測、可優化的系統。 一、什麼是週工作課表? 週工作課表不是單純的行事曆,而是一種「時間架構設計」。它將一週的工作分成不同功能區塊,例如: 策略思考(Strategy) 深度工作(Deep Work) 協作溝通(Collaboration) 行政與雜務(Ops / Admin) 透過固定節奏,可以減少切換成本,提升長時間輸出的穩定性。 從工作分類到週節奏的設計邏輯 上一段我們定義了四種工作型態,但真正要落地運作,關鍵在於「如何把這些分類轉換成一週的節奏安排」。 策略類工作:放在週初,確保思考品質與決策清晰度 深度工作:集中在中段,避免會議干擾與注意力分散 協作溝通:固定一天處理,避免打斷其他深度工作 收斂與復盤:放在週末前,形成完整閉環 因此,下方的表格並不是隨意安排,而是由這些原則推導出的「穩定工作節奏模型」。 二、標準週工作課表範例 星期 主軸 內容 一 策略規劃 週目標、架構設計、優先級排序 二 深度工作 核心專案開發 / 輸出 三 深度工作 技術 / 創作 / 解決問題 四 協作日 會議、對齊、跨部門溝通 五 收斂與回顧 整理成果、復盤、下週準備 三、這種方法的三個核心優勢 降低切換成本:同類型工作集中處理 提升專注深度:減少被動打斷 讓輸出可預測:形成穩定節奏系統 四、適合誰使用? 這套方法特別適合: 工程師 / 技術職(例如 BIOS /... » read more