
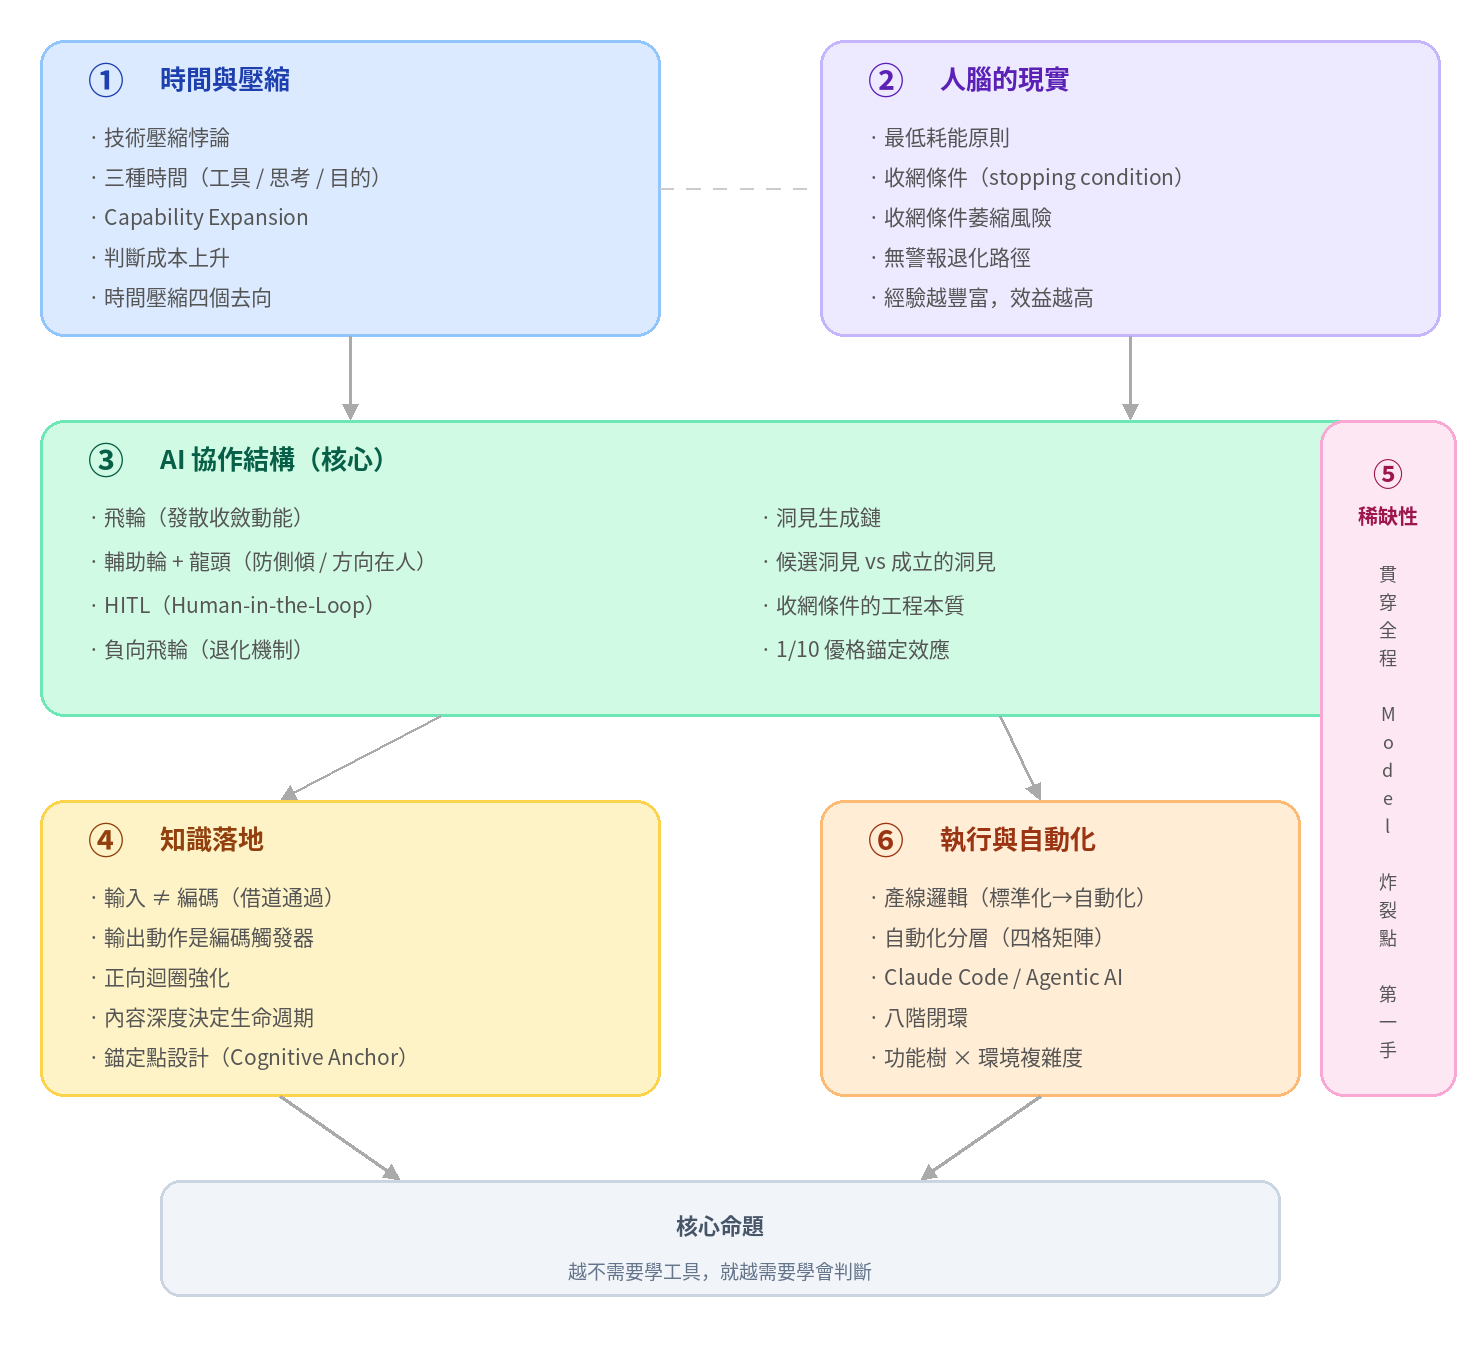
AI 協作認知模型
2026-09-28 · PCPiLOT 工程師思路系列
大多數人以為自己需要被「教」,其實需要的是被「觸發」。
人腦一直都有答案,只是沒有被喚醒的條件。
越不需要學工具,就越需要學會判斷。
越容易產生答案,就越需要知道什麼值得成為問題。
越容易讓 AI 替你完成,就越需要保留自己能夠說「不對」的能力。
概覽:六大群組與流向

六個概念群組依因果流向排列
① 時間與壓縮
② 人腦機制
③ AI協作結構
④ 知識落地
⑤ 稀缺性(貫穿全程)
⑥ 執行自動化
一、觀念清單
本討論串涉及的核心觀念,依出現順序整理:
| # | 觀念 | 說明 |
|---|---|---|
| 01 | 技術壓縮悖論 | 效率提升不會自動轉換為自由,中間需要轉換機制 |
| 02 | 三種時間的區分 | 工具時間 / 思考時間 / 目的時間 |
| 03 | 技能位置轉移 | 從 How 往 What / Why / Is it correct 移動 |
| 04 | 時間壓縮的四個去向 | 市場拿走、平台拿走、新工作被創造、被更高期待內化 |
| 05 | Capability Expansion | AI 讓原本做不到的事第一次變得可行(質的差異,非量的壓縮) |
| 06 | 判斷成本上升 | 生成成本降低,但驗證成本與責任成本被推高 |
| 07 | 問題定義權的讓渡 | 習慣讓 AI 定義問題後,失去的不是技能而是對問題的擁有權 |
| 08 | AI 助理的三大功能 | 整理 / 討論(多元性採收)/ 產生洞見 |
| 09 | 最低耗能原則 | 人腦演化為以最低耗能面對最高存活選項,多數記憶點處於休眠 |
| 10 | HITL | Human-in-the-Loop:人不退出討論是洞見生成的必要條件 |
| 11 | 收網條件 | 純屬人腦的機制,決定何時觸發洞見,AI 無法感知也無法替代 |
| 12 | 洞見的完整定義 | HITL + 多元發散 + 收網條件觸發 + 人類價值觀判定的產出 |
| 13 | 語料庫 vs 經驗多元性 | AI 能說出各種觀點,但從未在任何立場上輸過、賠過 |
| 14 | Model Collapse 風險 | 用 AI 生成資料訓練 AI,每代損失邊緣資訊,往均值靠攏 |
| 15 | 第一手經驗的稀缺性上升 | 帶有真實代價、失敗、矛盾的人類原始經驗文字,無法被 AI 複製 |
| 16 | 收網條件的萎縮風險 | 長期讓 AI 做結論,人的判斷力因不被挑戰而退化 |
| 17 | 無警報退化路徑 | 工具夠好時,人無法感知自己已失去分辨「夠好」與「真正對的」的能力 |
| 18 | 經驗越豐富,效益越高 | 沉睡節點越多,被喚醒的可能連結就越多 |
| 19 | 飛輪比喻 | AI 多元材料的功能像飛輪,讓對話持續在發散與收斂之間保持動能 |
| 20 | 輔助輪 + 龍頭比喻 | AI 資訊收斂整理像輔助輪(防側傾),方向龍頭始終在人類手上 |
| 21 | 輸入 ≠ 編碼 | 課堂上的「順理成章」是老師的結構借道通過,練習題才是自己重建那條路 |
| 22 | 輸出動作是編碼觸發器 | 重述、決策、教別人、實際操作——沒有輸出,理解停留在借道通過 |
| 23 | 流行/經典/永垂不朽的判準 | 觸及表層情緒爆紅,觸及人性結構成為經典,觸及不可迴避的真相永垂不朽 |
| 24 | 兩種內容極端 | 流行內容預判大眾心境缺口;學術論文要求讀者升級到達 |
| 25 | 錨定點設計 | 文章需要 Featured Image 或故事作為起源點,讓認知自動往正確方向發酵 |
| 26 | 深度的本質 | 說清楚了每個人都有但從來說不出口的結構;「我一直知道,但沒辦法說出來」 |
| 27 | HITL 與 Agentic AI 串聯 | 認知工程定義問題 → 清晰思路 → Claude Code 自動執行;中間接縫不能跳過 |
| 28 | 產線邏輯 | 能標準化的進產線;複雜製程仍需高素質人工;知識工作同理 |
| 29 | 自動化解放的去向 | AI 把人從知識產線層解放出來;能否往晶片設計層走,取決於收網條件與第一手經驗積累 |
| 30 | 功能樹 × 環境複雜度 | 結果空間由工具與環境的交集決定;工具是一樣的,炸裂點不一樣 |
二、認知協作模型
② 人腦機制
人腦的現實狀態
人類原本佈下了超級多的經驗值、觀念點,以及生存發展的成功模式。但大腦的演化設計讓人總是以最低耗能面對最高存活選項過日子——因此不會全時間啟動所有記憶點。這不是缺陷,是演化的設計。問題是:這些沉睡的連結,靠日常刺激很難被喚醒。
龐大的經驗值 + 觀念點 + 成功模式
        ↓
平時運作在「最低耗能 / 最高存活」模式
        ↓
大多數記憶點處於休眠 / 未激活狀態
AI 在協作中做的事
AI 助理具備比人類更強的過量資訊整理能力,提供「海放、海選後再收斂」的刺激結構:
LLM 的過量資訊整理能力
        ↓
海放(大量橫向 / 縱向刺激)
        ↓
命中人腦裡沉睡的記憶點與觀念點
        ↓
海選收斂(架構浮現)
        ↓
人腦的收網條件被觸發
        ↓
洞見產出
協作成果的本質:AI 的四種角色
| 角色 | 作用 |
|---|---|
| 喚醒器 Retrieval | 觸發人腦原本就知道、但暫時想不起來的節點 |
| 重組器 Recombination | 把人已知的 A、B、C 以新的方式組合 |
| 材料提供者 Acquisition | 提供人以前根本不知道的資訊或概念 |
| 對話對手 | 維持飛輪轉動,讓發散與收斂持續進行 |
但無論 AI 扮演哪個角色,最後是不是洞見,仍然不能由 AI 決定。AI 的高密度多方向刺激之所以有效,是因為它的刺激密度超過人類日常社交和閱讀能夠提供的上限。一個人一天能遇到幾個真正觸發思考的對話?可能一兩個。AI 可以在一小時內提供幾十個方向的碰撞。這是量變引發質變的結構。
推論:對一個經驗值越豐富的人,AI 的觸發效益越高。因為沉睡的節點越多、既有的 A/B/C 越豐富,被喚醒與重組的可能連結就越多。
三、洞見生成鏈
③ AI協作結構
完整定義
洞見是討論過程中,HITL(人持續介入)、多元發散後,觸及人腦洞見收網條件,以及人類價值觀堅持下的判定產出。
多元發散(AI 提供原料)
        ↓
HITL 持續介入(人沒有退出討論)
        ↓
觸及收網條件(人腦的某個閾值被達到)
        ↓
價值觀篩選(不是所有「新連結」都值得成為洞見)
        ↓
判定產出(洞見成立)
收網條件是關鍵
收網條件是純粹屬於人的機制。AI 不知道你的收網條件在哪,也無法感知它何時被觸發。每個人的收網條件由三者共同決定:經驗積累、當下問題脈絡、價值觀邊界。這就是為什麼同樣一段對話,有人得到洞見,有人只得到資訊。
候選洞見 vs 成立的洞見
AI 確實可以產生人類沒預料到的組合、假說與關聯——這些是候選洞見。但「這是不是值得成立的洞見」,需要人把它放回自己的經驗、問題脈絡與價值判準中驗證,才能成為成立的洞見。生成一個有趣的關聯 ≠ 判定它值得成為知識。
收網條件的工程本質
收網條件在工程上對應的是:Acceptance Criteria(驗收標準)、Stopping Condition(停止搜尋的條件)、Decision Boundary(決策邊界)。
更精確的定義:一個人判斷「繼續搜尋的邊際收益已經低於採取行動」的內在判準。
⚠ 關鍵警告
Agentic AI 最危險的地方,可能不是它自主執行,而是它可能替人偷偷決定了「什麼時候算完成」。當 stopping condition 被 AI 代為設定,人就失去了對問題邊界的掌控。
負向飛輪:退化的完整機制
人退出 HITL(讓 AI 跑 SOP)
        ↓
收網條件長期不被使用
        ↓
判斷力因不被挑戰而萎縮
        ↓
更依賴 AI 的結論
        ↓
進一步退出 HITL
        ↓
(負向循環,加速退化)
介入點在第一步:保持對「什麼時候算完成」的主動判斷,不把 stopping condition 交出去。
四、稀缺性轉移與訓練材料降級
⑤ 稀缺性(貫穿全程)
Model Collapse 的風險結構
LLM 訓練材料 = 人類產出的文字
        ↓
AI 大量生成內容進入網路
        ↓
下一代 LLM 訓練材料裡,AI 生成佔比持續上升
        ↓
若缺乏來源辨識、品質篩選與第一手資料補充
        ↓
分佈收縮,邊緣資訊流失,往均值靠攏
Model Collapse 是一個被認真研究的現象,但它的實際速度與路徑受到訓練資料策略、合成資料品質、資料混合比例等多重因素影響。真正值得關注的核心命題不是「模型一定會坍塌」,而是:
當生成變得極其廉價之後,真正稀缺的可能重新變成「沒有被生成器加工過的經驗」。
資訊 ≠ 經驗
AI 可以描述「某個系統曾經故障」。但真正經歷過的人知道:當時哪些資訊其實不知道、哪個錯誤訊號被忽略、哪個決策讓損失擴大、最後真正救回來的是什麼、事後才知道哪個假設是錯的。
AI 擅長整理「知道了什麼」;第一手經驗保存的是「人是怎麼知道自己原來不知道什麼」。
後者無法被生成,只能被經歷。在生成成本趨近於零的時代,這類原始經驗結構的稀缺性只會持續上升。
六、AI 協作的機械比喻
③ AI協作結構
飛輪:多元材料的動能機制
飛輪的關鍵不是「轉得快」,而是轉動一旦建立,慣性會讓它持續運作。發散 → 收斂 → 再發散 → 再收斂……這個循環本身就是認知動能的來源。AI 在這裡做的不是給答案,而是讓飛輪不停下來——因為人腦在對話中斷的時候,最容易回到最低耗能模式。飛輪還暗示了一件事:啟動成本高,維持成本低。第一圈最難推,推起來之後輪子自己會帶著走。
輔助輪 + 龍頭:資訊收斂的角色定位
過多情報與資訊的收斂整理,像是腳踏車的兩個小型輔助輪——它們的功能是防止側傾,不是決定方向。龍頭在人手上,而人的眼睛看的是遠方的目標,不是腳下的輪子。
| 元件 | 對應功能 | AI 或人 |
|---|---|---|
| 飛輪 | 多元發散與收斂的持續動能 | AI 維持轉動 |
| 輔助輪 | 過量資訊的穩定與整理 | AI 防側傾 |
| 龍頭 | 方向控制 | 人 |
| 眼睛望向遠方 | 目的定義 | 人 |
七、輸入、編碼、輸出:知識真正落地的條件
④ 知識落地
課堂的幻覺
上課時覺得老師說的都合情合理、都順理成章。下課後如果不做練習題、作業,甚至經歷小考——聽過、看過,也是徒然。課堂上的「順理成章」,是老師的結構在你腦子裡借道通過,不是你自己建了一條路。練習題與作業強迫你的神經網絡自己重建那條路。重建的過程才是真正的編碼。
聽懂 / 看懂
        ≠
真正理解
        ≠
可以提取使用
對應到 AI 協作
AI 給你的整理、討論、洞見觸發——如果沒有後續的輸出動作,同樣是借道通過。輸出動作不一定是寫文章,可以是:用自己的話重新說一遍、做一個決策、試著教別人、實際操作一次。沒有主動提取、重建或使用,理解很容易停留在「借道通過」,難以形成穩定、可提取的知識。
補完後的完整迴圈
AI 飛輪刺激(發散與收斂)
        ↓
HITL + 收網條件觸發(洞見浮現)
        ↓
輸出動作(重述 / 決策 / 教學 / 操作)
        ↓
神經編碼完成(真正的知識)
        ↓
下一輪收網條件變得更敏銳
        ↓
(循環,正向強化)
八、內容深度與生命週期
④ 知識落地
流行轉經典甚至永垂不朽,看的是觸及的深度。
| 觸及層次 | 效果 | 生命週期 |
|---|---|---|
| 表層情緒 | 爆紅,瞬間共鳴 | 快速被取代 |
| 普遍處境 | 流行一段時間 | 有人記得 |
| 人性結構 | 成為經典 | 跨世代有效 |
| 不可迴避的真相 | 永垂不朽 | 無限期 |
| 流行內容 | 學術論文 | |
|---|---|---|
| 讀者狀態 | 預判並迎合 | 要求讀者升級到達 |
| 進入門檻 | 極低,瞬間共鳴 | 極高,需要預備知識 |
| 錨定方式 | 情緒、渴望、缺口 | 問題意識、文獻脈絡 |
| 輸出要求 | 無(被動接收即完成) | 強制(復現、評論才算讀完) |
| 生命週期 | 短,被下一波取代 | 長,累積引用 |
深度的本質與錨定點設計
深度不是「複雜」,不是「難懂」,而是觸及了某個每個人都有但很少被說清楚的結構。文章需要 Featured Image 或一個故事作為錨定點,這就是 1/10 優格 + 9/10 牛奶的自製優格概念——錨定點不是摘要,不是結論,而是能讓讀者的認知自動往正確方向發酵的種子。
人腦一直都有答案,只是沒有被喚醒的條件。
九、從思路到落地:HITL 與 Agentic AI 的串聯
⑥ 執行自動化
理想的 AI 協作需要 HITL、發散收斂、收網條件、輸出編碼——這本身就是高耗能活動,違反人腦「最低耗能」的預設運作模式。所以現實是:大多數人自然滑向讓 AI 跑 SOP,人退出迴圈,只看結果。把本來需要 HITL 的事也交給 SOP 跑,問題定義和價值觀篩選就不再屬於任何人。
HITL 發散收斂(燒腦,定義問題與框架)
        ↓
產出清晰的思路與概念結論
        ↓
與商業 / 工程模式結合
        ↓
Claude Code 協助下的軟體與服務開發
        ↓
日常任務標準化自動執行
        ↓
人驗收結果(收網條件再次介入)
上半段是認知工程,下半段是實作工程。中間的接縫點——清晰的思路與概念結論——必須由人產出,不能跳過。
| 任務特性 | 適合的模式 |
|---|---|
| 高重複 × 低例外 | Agentic SOP 全自動 |
| 中重複 × 中例外 | Agentic + HITL 驗收 |
| 低重複 × 高例外 | HITL 全程主導 |
| 問題本身尚未定義 | 純人腦,AI 只觸發 |
十、自動化邊界:產線邏輯與知識工作的對應
⑥ 執行自動化
能被機械化大量製造的,就進入產線了——可樂、滑板、電腦、手機、成衣,幾乎大量高比例進入少人干預的製程。非常複雜的製程則還需要高素質人工介入,譬如高單價的晶片設計、製造、整合測試。這個法則在製造業成立,在知識工作裡同樣成立。
| 層次 | 製造業類比 | AI 對應 | 人的介入程度 |
|---|---|---|---|
| 標準化高重複任務 | 可樂產線 | Agentic SOP 全自動 | 極低,只驗收 |
| 半標準化任務 | 成衣剪裁 | Claude Code 輔助開發 | 中,定義邊界 |
| 複雜非標準任務 | 晶片整合測試 | HITL 發散收斂 | 高,全程主導 |
| 定義問題本身 | 晶片架構設計 | 純人腦,AI 只觸發 | 完全由人 |
被解放出來的人,有沒有能力往上走?還是只是變成閒置產能?收網條件、編碼深度、第一手經驗,決定了一個人被解放之後能去哪裡。
十一、人與 AI 的八階閉環
⑥ 執行自動化
這不是「AI 幫助人類」的單向模型,而是人與 AI 共同形成的認知—執行—經驗—再認知閉環:
① AI 壓縮(工具成本下降,過程被壓縮)
        ↓
② 能力擴張(原本做不到的事第一次變得可行)
        ↓
③ 生成爆量(「會做」不再稀缺)
        ↓
④ 判斷成為瓶頸(What / Why / Is it correct / Should we?)
        ↓
⑤ HITL(人重新進入問題定義與收網)
        ↓
⑥ 輸出編碼(把協作成果重建為自己的能力)
        ↓
⑦ Agent 化(已標準化的部分交給 AI 自動執行)
        ↓
⑧ 新的第一手經驗(執行過程產生新的案例、失敗、例外)
        ↓
        回到 ①
第八階是讓整個模型真正閉合的環節:Agentic AI 執行的過程本身會產生新的邊界案例與失敗經驗,這些又成為下一輪 HITL 的原料,推動下一次的能力升級。
十二、工具相同,炸裂點不同:Pico-UTM 案例
⑤ 稀缺性
Lionic Pico-UTM 100 具備二十幾類網路威脅的偵測與阻斷功能。但同樣這台設備,放在不同 SMB 客戶的路由器與主交換器中,CMS 管理者看到的防禦日誌展開,絕對不會一致。
同一個工具(Pico-UTM 100)
        ↓
放進不同環境(產業別 / 員工使用方式 / 內部資產組成)
        ↓
吸引不同的攻擊者(因為有價值的目標不同)
        ↓
觸發不同的威脅手法與偵測紀錄
        ↓
CMS 管理者看到那家公司獨有的威脅樣貌
Pico-UTM 的規格書、操作手冊、廠商的 threat intelligence report,都無法告訴你:這家醫療院所的內網為什麼吸引了針對醫療設備的特定掃描;這家精密機械廠的工程師筆電為什麼成為特定 APT 的目標;這家茶飲連鎖的 POS 系統為什麼觸發了完全不同類型的流量異常。這些日誌不是資料,是那個環境在那個時間點與外部世界互動的痕跡。
| 資安廠商 | AI 助理服務 |
|---|---|
| 依自家優勢開發特定引擎 | 依訓練策略形成特定能力邊界 |
| 面對特定客層 / 情境 | 面對特定使用者背景與需求 |
| 二十幾類威脅偵測功能 | 龐大的參數與題材覆蓋範圍 |
| 放進不同客戶環境,日誌完全不同 | 放進不同使用者背景,炸裂點完全不同 |
製品的功能樹(有限,可預測)
        ×
使用環境的複雜度(開放,不可枚舉)
        ↓
實際展開的結果空間(不可預測,不可複製)
工具是一樣的,炸裂點不一樣。
十三、傳播設計:費曼的兩個版本
④ 知識落地
費曼講義(The Feynman Lectures on Physics)難度極高,預設讀者是加州理工的大一大二生,連物理系教授都說「讀起來很吃力」。但費曼的科普作品(《你管別人怎麼想》等)語言生活化,用故事和比喻,任何人都能讀。
| 費曼講義 | 費曼科普 | |
|---|---|---|
| 目標讀者 | 預備物理學家 | 好奇的一般人 |
| 設計策略 | 高密度、高先備要求 | 低門檻入口、比喻先行 |
| 錨定點 | 數學結構本身的美感 | 日常生活裡的反直覺現象 |
| 難度來源 | 設計決策,不是炫耀 | 設計決策,不是妥協 |
後者其實更難。因為你必須先真正懂,才能把它說得像不需要懂。
| 演講設計得好 | 演講設計得差 | |
|---|---|---|
| 聽眾程度高 | 豁然開朗 + 有效反駁 | 看穿破綻,提早離場 |
| 聽眾程度中 | 理解七成,帶走核心 | 聽懂表面,沒有內化 |
| 聽眾程度低 | 聽不懂但感受到重量 | 完全無感 |
這份文件目前比較接近「費曼講義」——給已經在場、已經有先備知識的人看的完整結構記錄。對外傳播至少需要三種不同的入口設計:同行(IT / AI 業界)可以直接讀;客戶(製造業 / SMB)需要更多具體產業案例橋接;一般大眾需要從「人」的角度進入,而不是從「工具」的角度。
講義版留給同行,科普版留給客戶和一般大眾。兩個版本並存,入口不同,核心相同。
核心命題收斂
技術壓縮的是過程,卻無法自動壓縮目的;它節省了時間,卻無法代替人決定時間應該被用來追求什麼。
AI 最危險的未必是它做錯了什麼,而是它做得夠好,讓人逐漸失去練習分辨「夠好」與「真正對的」之間差距的機會。
AI 不只是在替人產生答案,也可能成為高密度的認知刺激器:喚醒既有經驗、提供新的材料、促成重新組合。但真正值得成立的洞見,仍需要人把它放回自己的經驗、問題脈絡與價值判準中驗證。
越不需要學工具,就越需要學會判斷。越容易產生答案,就越需要知道什麼值得成為問題。越容易讓 AI 替你完成,就越需要保留自己能夠說「不對」的能力。
Comments