
PCPILOT · 工程師思路系列 · 完整合輯
AI 助理年代的知識工程
壓縮 · 回收 · 拓撲 · 重建
工程師思路系列 · 四篇合輯 · 2026-09-19
工程師思路系列 · 第一章
AI 助理在做什麼?壓縮,以及解壓縮
AI 不是在幫你「寫東西」,它在幫你處理資訊的密度——把太多的壓少,把太少的展開。但這件事比看起來複雜得多。
你有沒有遇過這種情況:跟 AI 討論了很久,它整理出一份漂亮的摘要,但你讀完之後,隱隱覺得有什麼東西消失了。不是少了幾個字,而是——某些你覺得重要的東西,不見了。
這不是 AI 的 bug。這是壓縮機制運作的必然結果。而理解這件事,可能比學會怎麼下 prompt 更重要。
一、從一個簡單的比喻開始
前陣子看到一段網友的感想,把 AI 助理的工作用兩個詞說清楚了:
資訊的壓縮,以及解壓縮。
壓縮:把大量的會議記錄、研究數據、討論內容,整理成有條理的文件。
解壓縮:把你腦中一句模糊的想法,展開成完整的論述。
這兩件事合在一起,就是大多數人每天在用 AI 做的事情。我自己寫計畫和報告,就是這樣用的——讓 AI 幫我把散亂的想法壓縮成結構,或者把一個粗略的方向展開成完整說明。
但這個描述看起來簡單,實際上藏著幾個很重要的問題,值得一層一層說清楚。
二、人類的一句話,可能是一整座知識庫
先從「解壓縮」說起。
一個有二十年現場經驗的機械工程師,看了一份新的維修方案之後,只說了一句話:
「這個方案有問題。」
六個字。
但這六個字背後,可能包含:他踩過的坑、記憶中的失敗案例、對設備材質特性的直覺、對操作人員行為的長期觀察、對環境溫濕度的敏感度,以及一個尚未完整說出口的因果模型。
AI 如果只看到文字,看到的就只是「六個字」。但對說話的人而言,那六個字是一整座知識庫的入口。
這讓 AI 的解壓縮工作,遠比一般人想像的困難:
AI 不只是要把外部資訊展開給人類看。更難的,是把人類自己腦中已經高度壓縮的經驗,重新解壓縮出來。
這也是為什麼,在跟 AI 討論的過程中,往往需要好幾輪來回。不是 AI 不夠聰明,而是你腦中那座知識庫,本來就不是一兩句話能交代清楚的。
📌 為什麼「多輪對話」是必要的,不是浪費時間?
人類專家的一句話,通常是數年經驗高度壓縮的結果。AI 沒有辦法一次性讀懂那個密度。所以有效的人機協作,往往需要透過多輪對話,讓 AI 逐步逼近你真正想說的東西——就像一個外人在聽你解釋一個它從未接觸的領域,需要問很多問題才能真正理解。
三、壓縮,不是中性的動作
現在說「壓縮」。
在一次長時間的多輪討論之後,某個 AI 把整個對話整理得非常漂亮——結構清晰、段落分明、重點突出。我讀完之後覺得有什麼地方不對勁,仔細對照之後發現:
它把我們走過的幾條「彎路」整理掉了。
那些彎路,表面上跟主題沒有直接關係。AI 的判斷是:不重要,省略。
但問題就在這裡:
壓縮本身就是一種判斷。
「把什麼留下、把什麼丟掉」——這個決定,本身已經包含了對資訊價值的判斷。而這個判斷,AI 是代替我做的,在我還沒有意識到、更沒有授權它的情況下。
這不是 AI 在偷懶或欺騙你。它只是在做它被設計來做的事:把資訊整理得更精煉、更有效率。但這個「效率」的定義,是從任務型對話的角度出發的——越快到達結論越好。
研究型的思考,不是這樣運作的。
📌 AI 系統的記憶體限制,為什麼會影響你的思考?
AI 系統在長時間的多輪對話中,面對實際的 Token(運算單位)和 Context(上下文記憶體)限制,無法把所有細節永遠放在工作空間裡。它必須壓縮,這是技術上的必然,不是偷懶。問題是:壓縮的標準是什麼?AI 傾向保留「當前最相關的」,捨棄「目前看起來偏離主題的」。這對效率型任務非常合理,但對思考和研究來說,那些「偏離主題的東西」可能恰好是日後洞見的種子。
四、彎路,是未來洞見的候選材料
一般的工作任務,追求最短路徑。A → B → C,越快收斂越好。
研究和思考的路徑,通常長這樣:
A → B → C
         ↘ D
           → E
      ↖
      重新想到 B
           → F
最後的洞見:D + E + F 突然接通
D 和 E,看起來都是繞路。如果你請 AI 把這段討論整理成「重點摘要」,D 和 E 很可能會消失——因為它們跟最後的結論 C 沒有明顯的直線關係。
但如果 D + E + F 才是最後真正產生洞見的組合,那麼這份「漂亮的摘要」,實際上已經把最有價值的東西丟掉了。
這裡有一個很重要的認知分界:
AI 可以判斷一個資訊現在的相關性。
但它未必知道那個資訊未來的啟發價值。
「這個概念現在跟主題有多接近」,和「這個概念未來可能會跟哪個東西突然接通」——這是兩個完全不同的函數。AI 很擅長前者,但對後者幾乎沒有判斷能力。
原因很簡單:後者取決於你這個人的認知背景、你的知識結構、你還沒想到的那些連結。AI 不在你腦子裡,它沒辦法替你預測哪條彎路之後會變成捷徑。
對任務型對話,彎路可能是浪費。
對研究型作者,彎路可能是突觸的候選材料。
📌 「突觸」的比喻是什麼意思?
人類大腦的學習,依賴神經元之間形成新的連結(突觸)。一個資訊單獨存在時可能沒有意義,另一個資訊也是。但當兩者被放在一起,突然「接通」——就是「原來如此」的那一刻。這個接通的條件,不是純粹靠邏輯推算,而是靠你腦中已有的前置知識與背景經驗。所以有些「繞路」不能少走,因為那些路正在替未來的接通建立基礎。
五、四個 AI 同意,不代表四個獨立證據
我平常寫計畫或報告,習慣比對好幾家 AI 的建議,再由其中一家做主筆整理。這個習慣我覺得是對的,但原因跟我一開始以為的不太一樣。
一開始我以為:四個 AI 都同意,代表這個答案比較可靠。
但後來發現一個問題——不同的大型語言模型,訓練時使用的公開資料高度重疊:同樣的學術論文、同樣的網路文章、同樣的技術文件。它們的推理模式也可能非常相近。
四個 AI 同意,不代表四個獨立的觀點。
有時候更像是:同一個認知框架,被問了四次。
這不代表使用多個 AI 沒有意義,而是「使用多 AI 的真正目的」需要重新定義。
AI 的價值,至少有三個不同的維度:
| 維度 | 問的問題 | 常見誤解 |
|---|---|---|
| 正確性 | 這個答案是對的嗎? | 多個 AI 同意 = 正確性更高 |
| 多元性 | 有沒有我沒想到的角度? | 多個 AI = 自動產生多元觀點 |
| 啟發性 | 它能把我帶到原本沒想到的地方嗎? | (這個維度最常被忽略) |
使用多個 AI,真正的目的應該是第二和第三個維度——讓思考的覆蓋面更廣,而不是讓「有幾個 AI 同意」這個數字變大。
📌 模型知識重疊,是一個值得關注的長期趨勢
隨著 AI 模型的訓練成本上升,各家實驗室都在吸收人類社會已有的大量公開知識。這些知識本身有很大的重疊。長期來看,如果模型之間的思考框架越來越接近,「多叫幾個 AI 回答」可能越來越不等於「多元觀點」。真正的多元性,可能需要刻意設計不同的思考角色、假設前提、或跨領域的連結方式——而不只是多問幾個模型。
六、洞見可能不在任何一個 AI 的答案裡
這裡有一個更深的現象值得說明。
在使用多個 AI 討論一個複雜問題時,有時候真正有價值的東西,不是任何一個 AI 直接給出的答案,而是:
- AI A 給出一個觀點。
- AI B 給出另一個,跟 A 有點矛盾。
- AI C 指出一個你原本沒注意到的假設。
- AI D 從一個完全不同的領域切入。
你把這四個東西重新放在一起,突然發現:A + B + C + D 之間,存在一條以前沒有看見的關係。
從多點之間躍昇出一個原本不存在的洞見。
真正需要的,不是更多 AI 答案,而是更多思考的可能性。
這讓 AI 的角色從「答案機器」,轉變成了一種「思考空間擴張器」。它的價值不在於它說了什麼,而在於它讓你有沒有想到一些原本不會想到的東西。
七、人類必須保留「先不要丟」的權利
說回到壓縮這個核心問題。
我們已經確認了:AI 在壓縮資訊時,會做判斷;它的判斷標準是「當前相關性」;而當前相關性不等於未來啟發價值。
所以在人機協作中,有一條很重要的邊界需要守住:
當人類還不知道某個資訊未來有沒有用的時候,人類必須保留「這個先不要丟」的權利。
這不是說什麼都要永遠保存。而是:取捨這件事,不應該在不知不覺中被 AI 代勞,在你還沒意識到的情況下發生。
更深的問題其實是:
AI 的核心問題,可能不是「能不能記住更多」,而是「誰有權決定什麼值得被記住」。
這個問題,在 AI 用來輔助一般任務時並不重要。但當你用 AI 來輔助知識生產、研究思考、或長期的決策積累時,它就變得非常關鍵。
八、「不對喔,你講錯了。」——最重要的協作機制
這個場景你一定遇過:
AI 說了一段看起來很合理的分析,但你讀完之後直覺告訴你:哪裡怪怪的。
你說:「不對喔,我以前遇過類似的狀況,不是這樣的。」
這不是在對抗 AI,也不是在展示自己比 AI 更聰明。這是人機協作中最重要的校正迴路。
你的鍥而不捨、你的執念、你多年累積的現場感——在這裡不是障礙,而是 AI 的錯誤偵測器。
AI 助理的訓練傾向,是理解使用者、延續使用者的問題脈絡、幫忙完成目標、讓對話繼續推進。這對一般任務非常有用。但研究型思考可能需要的是:反方、質疑、異議、前提檢查、從另一條路強行走一次。
理想的 AI 協作者,甚至應該在適當的時候反過來問你:
「你的前提,有沒有可能就是錯的?」
這才是真正有價值的協作——不是 AI 永遠順著你走,而是它有能力撞擊你原本的認知框架,讓你不得不重新確認自己的假設。
📌 AI 的「順著你走」,有時候是風險
大多數 AI 助理的設計目標,是讓使用者滿意、讓對話順暢。這代表它在大多數情況下,會傾向確認你的想法,而非挑戰它。對於需要批判性思考的工作——比如風險評估、方案審查、研究假設的驗證——這個傾向可能反而是隱患。一個好的工作方式是:主動請 AI 扮演反方角色,或直接問它「這個方案最可能在哪裡出問題」,而不是只問「這樣對不對」。
九、每個人的認知管道不同,洞見的觸發條件也不同
到這裡,還有一個層次需要說明,跟「解壓縮」這件事有關。
同樣一段文字,不同的人讀完之後的反應不同:
- 甲讀者看到 A,因為他剛好有類似的背景。
- 乙讀者看到 B,因為他正在處理一個相關的問題。
- 丙讀者想到自己十年前的一個案例,突然接通了。
- 丁讀者把兩個完全不同領域的東西連在一起,因為他跨界工作。
這不是讀者理解能力的差異,而是每個人的認知基底本來就不同——背景知識、工作經驗、失敗記憶、專業訓練、特殊興趣,構成了每個人獨特的「認知管道」。
點亮理解、開啟洞見的條件,本來就不可能對每個人完全相同。
這對 AI 的工作有一個很重要的含義:AI 提供的是一個共同的知識空間,但每個人從這個空間裡取出什麼,取決於那個人的認知結構。
所以真正有價值的文章或知識產出,不一定是資訊最多的,而可能是:
讓不同背景的讀者,都能在自己的認知結構裡,找到可以接上的節點。
這也是為什麼,好的科普文章不是把所有細節都塞進去,而是要在適當的地方留下足夠的「接口」,讓讀者的背景知識可以掛上去,讓理解自然發生。
十、LLM 真正需要協作的,是理解層,不只是答案層
把前面所有的層次整合起來,可以看到一個更完整的圖景。
AI 幫你做的,其實是一個持續的壓縮與解壓縮循環:
世界的大量資訊
  ↓ AI 壓縮
結構化知識
  ↓ AI 解壓縮
多種可能的觀點與詮釋
  ↓ 你的背景知識介入
個別化理解
  ↓ 發散(包含彎路)
多點接通
  ↓ 洞見出現
你的判斷
  ↓ 重新壓縮
新的知識模型(文章、決策、方法)
  ↓ 發表
成為其他人的輸入
  ↓ 再次被解壓縮...
這已經不是「AI 幫我寫文章」這個簡單的描述能夠涵蓋的。
這是一個人類 × LLM 的知識循環。
在這個循環裡,AI 的角色不只是工具,也不是替代品。它是一個協作者,負責的是:
- 把你說不清楚的東西幫你展開。
- 把太多的資訊幫你整理成結構。
- 把你還沒想到的角度主動提出來。
- 在你說「不對喔」的時候,誠實地重新來過。
而這些事情,都不是在「答案層」發生的。它們發生在更前面的地方——在你還在想清楚自己要什麼的過程中。
LLM 不只是要跟人類的答案協作,而是要跟人類的理解方式協作。
十一、回到最初:這年費值不值得?
這年費 NT$6,000,值不值得?
看投報比,答案通常是:值得的。只要你依賴 AI 協作的成果,已經明顯轉化成收益,甚至深化成基礎架構的一部分,這個問題就不難回答——就像你不會問行動電話費值不值得一樣。
但這篇文章真正想說的,不是這個。
更值得問的問題是:
你有沒有在用對的方式跟它協作?
你有沒有守住那些「AI 替你決定丟掉」的東西?
你有沒有保留住「這個先不要丟」的主導權?
AI 能幫你壓縮世界,也能幫你解壓縮思考。但壓縮本身就是判斷,而這個判斷,不能全部外包出去。
LLM 提供的是一個巨大的可能性空間。你提供的,是你這個人的認知結構、背景知識、以及那些只有你踩過才懂的坑。兩者之間需要一個持續的協調——而這個協調,目前還必須由你來主導。
工程師的工作方式,從來就是這樣:看到工具的限制,理解它,然後最大化利用它的優點,同時繞開它現階段一定會踩到的坑。
AI 也是一樣。工具會進步,坑也會改變。現在最重要的事,是知道這一代的坑在哪裡——然後繞過去。
工程師思路系列 · 第二章
你燒掉的 Tokens,最後留下了什麼?
AI 把知識生成的成本壓低了,卻可能把知識回收的成本推高。最慘的狀況不是 AI 沒幫到你,而是它幫你想通了一件事,然後那個洞見就這樣消失在某個對話串的第 47 則訊息裡。
這篇文章從一個有點好笑、又有點痛的現象開始說起。
一、AI 訂閱費,是一種很特殊的痛感
傳統 SaaS 的費用,通常是一種「一次性的鈍感」:
年費刷卡,然後幾乎感覺不到。除非帳單來了才想起來,「喔對,我有訂那個。」
AI 助理的成本結構完全不一樣。它把使用成本拆成三個會持續刺激感知的東西:
- 年度訂閱費——「我為這個 AI 買單了。」
- Tokens 消耗——「剛才那一大串討論,真的吃掉這麼多計算資源。」
- 五小時用量上限——「咦?才用了幾輪,怎麼又快到上限了?」
第三個尤其有意思。它把原本藏在雲端機房裡的「算力稀缺」,直接變成使用者介面上的倒數感。
於是 AI 使用出現了一種以前 SaaS 很少有的心理模型:
傳統軟體:我買了一套工具。
AI:我正在消耗一種東西。而且這個東西會流逝。
Tokens 是流量計。用量上限是油箱。Reset time 是下一次補給時間。訂閱費是入場費。
這個設計,讓使用者自然開始問一個以前很少問的問題:
「這一輪對話值不值得?我今天燒掉的 Tokens,最後留下了什麼?」
📌 Token 是什麼?
Token 是 AI 語言模型處理文字的基本單位,大約等於英文的 0.75 個單字,或中文的 1 個字左右。每一次你輸入問題、AI 輸出回應,都在消耗 Token。長對話、複雜推理、大量來回,會消耗更多。Token 的消耗量直接對應 AI 服務商的運算成本,因此多數訂閱方案都設有用量限制——有些以每日上限計,有些以每五小時的使用額度計。
二、Token 讓「時間」第一次有了數位代理物
還有一個更深的現象值得注意。
你今天花兩個小時跟 AI 討論一個架構問題。人腦的感覺可能只是:「今天又聊了一個下午。」
但 AI 系統可以把這件事呈現成:
這場討論消耗了 X tokens
使用了 Y 次推理
剩餘額度 Z%
距離 reset 還有 N 小時
於是「時間」第一次有了一個非常具體的數位代理物。
不是:「我浪費了兩小時。」
而是:「我燒掉了這麼多計算資源,最後留下了什麼?」
這個問法,會逼使用者開始思考 ROI——不是財務上的,而是認知上的:
我今天燒掉的 Tokens,有多少被轉換成了明天不用再燒的 Tokens?
真正成熟的 AI 使用者,追求的不是「每天可以問幾次」,而是「這次對話的知識,有沒有沉澱下來,讓下一次變得更有效率」。
一次昂貴的 AI 對話,如果只是消失在聊天記錄裡,它就是消耗。如果它最後變成一個可重複使用的知識模組,它才開始變成資產。
三、最慘的不是 Tokens 燒光了
說到這裡,有一個更根本的「慘」值得說清楚。
最慘的狀況,不是用量上限到了。
而是:我們把最昂貴的東西——自己的注意力、AI 的推理、跨模型來回碰撞出的洞見——產生出來之後,沒有把它帶走。
具體來說,是這種場景:
Claude  → 建構第一個模型
ChatGPT → 找出隱含假設
Gemini  → 拉出外部脈絡
Grok    → 從另一個角度撞擊
你      → 把幾個模型重新組合,再回頭問 AI
              ↓
    某個地方「啪」的一聲接上了
那一聲「啪」的瞬間,是整個知識旅程最有價值的東西。
但它存在於哪裡?
不在任何一個 AI 的答案裡。它存在於:A 為什麼引出了 B,B 為什麼讓你想到 C,C 又推翻了原本的 D——這整條走過的路,以及路上發生的每一個轉折。
如果最後只剩下:
ChatGPT 對話串 #1847
Claude conversation #92
Gemini chat #301
那就等於把一條已經走完的山路,重新埋回森林裡。
AI 把知識生成的成本壓低了,卻可能把知識回收的成本推高。
四、摘要,還不夠
直覺上,解法好像是「把對話整理成摘要」。
但摘要通常只留下:結論。
而真正珍貴的知識旅程,需要留下的是:
問題 → 分支 → 碰撞 → 修正 → 關聯 → 觸發 → 洞見 → 新問題
這兩者有根本上的差異。
結論可以讓你「知道答案」。但知識旅程可以讓你「理解這個答案是怎麼來的」——以及在哪些前提下它成立、在哪裡它可能不成立、它打開了哪些新的問題。
更重要的是:結論是靜態的,知識旅程是可以再出發的。
一個留下了完整旅程的知識節點,下次你想繼續往前走,不必從零開始。你可以從上次停下來的地方,重新解壓縮,再繼續。
一個只留下結論的摘要,下次你想繼續,你得重新走一遍那條路——如果你還記得路在哪裡的話。
📌 「Conversation Summary」和「Knowledge Journey」的差異
Conversation Summary 在問:「這段對話在講什麼?」
Knowledge Journey 在問:「這段對話之間,發生了什麼?」
前者保存的是內容的截面。後者保存的是思考的路徑——包含走錯的岔路、被推翻的假設、突然接通的瞬間、以及那個接通留下的新問題。對研究型的知識工作者來說,後者的價值通常遠高於前者。
五、AI 越強,這個問題越嚴重
這裡有一個非常反直覺的現象。
弱 AI 的時代,問題比較好整理:
問一個問題 → 得到一個答案。
整理容易,知識旅程短。
強 AI 的時代:
問一個問題
  → 展開十個方向
  → 發現三個隱藏假設
  → 又牽涉到五個領域
  → 再找另一個 AI 驗證
  → 發現原假設其實不完整
  → 建立新模型
  → 又產生七個值得研究的新問題
知識探索的樹狀空間開始爆炸。
但人的記憶、時間與注意力,沒有同步擴張。
所以最後很可能不是:
「AI 沒有幫我找到答案。」
而是:
「AI 幫我找到太多東西,但我來不及把它們收回來。」
這不是 AI 的問題。這是一個工具能力的擴張速度,遠超過人類知識回收基礎設施的問題。
📌 知識爆炸不是新問題,但 AI 讓它加速了
人類社會從印刷術發明以來,就一直面對「產出的知識遠多於能消化的知識」這個問題。學術期刊的爆炸、網路資訊的洪流,都是這個問題的不同版本。AI 的出現,讓「個人層面的知識生產」也開始面對同樣的困境——不再只是世界的知識太多,而是你自己跟 AI 一起生產的洞見,也開始多到你自己收不回來。
六、值得保存的,不只是「我最後知道了什麼」
這裡有一個瞬間,每個認真使用 AI 的人都經歷過,但很少被說清楚。
就是那個「啪」的瞬間——幾個原本不相干的概念突然接通,你突然理解了一件以前模糊的事。這種感覺有時候被叫做「打通周身經絡」,有時候叫「醍醐灌頂」,有時候只是一句「原來如此」。
這個瞬間,在認知科學上有一個名字:相變(Phase Transition)。
它不是漸進的理解,而是一個突然的結構性改變——你的認知模型從一個狀態,跳到了另一個狀態。
問題是:這個相變的過程幾乎不可能只靠「結論」來重現。
你需要保留的,是讓你走到那個相變點的整條路——包含哪些前置概念被鋪陳、哪個矛盾被提出、哪個假設被推翻、最後哪兩個點突然接通。
真正值得保存的,不只是「我最後知道了什麼」。
還有:「我是怎麼從不知道,走到突然全部接通的。」
因為這條路,對你下一次的思考有用。對你想把這個洞見傳遞給別人也有用。對你自己六個月後重新回來看這個問題,也有用。
七、需要的工具,不是更漂亮的聊天視窗
說到這裡,可以整理出一個很具體的需求:
我們需要的,不是再做一個更漂亮的 AI 聊天介面。
我們需要的,是一個能把散落在多個 AI 對話裡的認知旅程,重新編織成知識地圖的工具。
它應該問的不是:「這幾段對話在講什麼?」
而是:「這幾段對話之間,發生了什麼?」
原始問題
   │
   ├── Claude:建立第一模型
   │       │
   │       └── 發現假設 A
   │
   ├── ChatGPT:質疑假設 A
   │       │
   │       └── 產生觀點 B
   │
   ├── Gemini:補充外部脈絡
   │       │
   │       └── 連接 C
   │
   └── 你:重新組合
           │
           ▼
       洞見 D
           │
           ▼
     值得保存的新原理
           │
           ▼
     下一個值得探索的問題
這樣保存下來的,就不再只是「聊天記錄」。
而是:一條已經走過、驗證過、可以再次出發的知識路徑。
下次重新開啟這個主題,不是從零開始,而是從這張地圖的某個節點,繼續往前走。
📌 這個需求,已經有人在嘗試解決
目前市面上有幾個方向在處理這個問題:個人知識管理工具(PKM)如 Obsidian、Logseq,試圖用雙向連結讓概念之間的關係可見;AI 記憶功能(如 ChatGPT 的 Memory、Claude 的 Projects)試圖讓 AI 記住跨對話的上下文;更進一步的研究方向則是「知識圖譜 + LLM」的結合,讓 AI 不只回答問題,也能追蹤推理路徑。但目前沒有任何工具,能完整捕捉「跨多個 AI、跨多輪對話的知識旅程」——這個缺口,目前還必須靠使用者自己用紀律來填補。
八、從 AI 對話時代,走向 AI 知識累積時代
把這篇文章的脈絡整理成兩個對比,可能是最清楚的方式:
| AI 對話時代 | AI 知識累積時代 |
|---|---|
| 問問題,得答案 | 問問題,留旅程 |
| 消耗 Tokens,得到結論 | 消耗 Tokens,沉澱知識節點 |
| 每次從零開始 | 每次從上次停下的地方繼續 |
| 洞見埋在對話串裡 | 洞見變成可重複使用的知識模組 |
| AI 是答案機 | AI 是知識加工設備 |
從第一欄走到第二欄,需要的不只是更好的 AI。
它需要使用者有意識地改變工作方式——把「每次對話的產出」,從即用即棄的答案,變成可以累積的知識資產。
而這個改變,目前主要還是靠使用者自己的紀律來驅動,不是 AI 工具自動幫你做到的。
九、工程師的解法:先把坑說清楚,才能設計繞法
這篇文章的目的,不是給你一套完整的解決方案——因為這個問題目前沒有標準答案,工具還沒跟上,每個人的工作型態也不一樣。
但工程師的工作方式,向來是這樣的:先把坑說清楚,才能設計繞法。
所以至少,在你下一次跟 AI 進行一場你覺得「有點感覺」的討論之後,可以先問自己這幾個問題:
- 這場對話裡,有沒有一個「啪」的瞬間?如果有,那個瞬間是在哪裡發生的、什麼條件觸發的?
- 我帶走的是結論,還是旅程?我能不能在一個月後重新走回這個思考節點,而不必從頭開始?
- 這些洞見,有沒有被存在一個我找得到的地方?還是它正在某個對話串的第 47 則訊息裡,慢慢沉沒?
- 這次消耗的 Tokens,有沒有被轉換成下次不用再燒的知識?
這四個問題,可能比任何 AI 工具的功能介紹都更實用。
AI 不是免費的答案機,而是一台會消耗算力的知識加工設備。
加工出來的東西,值不值得,取決於你有沒有把它收回來。
Token 會 reset,洞見不會自動等你。
工程師思路系列 · 第三章
AI 把圖壓成了線
一本書如果沒有目錄,你很難直接跳到你要找的地方。一部電影如果沒有簡介,你沒辦法在兩分鐘內判斷值不值得看。YouTube 影片有時間軸,工程文件有架構樹,課程有章節——這些東西存在,是因為人類沒有辦法用平行處理的方式掃描線性內容。
AI 幫你把兩個小時的討論整理成一篇文章之後,你卻站在那篇文章前面,突然發現一件事:
你沒辦法一眼確認,這篇文章是不是你兩個小時前走過的那條路。
這不是 AI 寫得好不好的問題。這是一個更根本的「人類認知介面」問題。
一、目錄、時間軸、架構樹——都是人類的外接平行處理器
先從一個熟悉的問題說起。
為什麼書要有目錄?不是因為沒有目錄你就看不懂,而是因為目錄讓你可以在不線性閱讀的情況下,回答幾個基本問題:
- 我現在在哪裡?
- 我要找的東西在哪一節?
- 前面還有什麼?後面還有什麼?
- 這一章跟另一章之間有什麼關係?
YouTube 影片有時間軸標註,是同樣的道理。電影有劇情簡介,課程有章節,工程文件有架構樹:
Architecture
 ├─ Network
 ├─ Storage
 ├─ Security
 └─ Backup
這些東西共同解決的,是同一個問題:
不要逼人類從第一秒開始線性掃描,才能知道全貌。
人類的工作記憶有限,注意力有時間成本,沒辦法像 AI 一樣在六秒內把整篇文章的結構平行載入。所以這些導航工具的存在,不是裝飾,而是人類認知的外接補償機制。
少了它們,你面對長內容的唯一選項,就是從頭線性掃描。
二、AI 對話,是一個非常奇怪的線性世界
現在回到 AI 對話。
你跟 AI 討論了兩個小時。對話介面保存的是這樣的東西:
01:00 你問 A
01:05 AI 答 B
01:12 你問 C
01:21 AI 答 D
01:37 你問 E
01:48 AI 答 F
02:00 洞見 G 出現
但你的實際認知路徑,可能長這樣:
             B
            ↗
A ────────→ C ──────→ F
│           ↘        ↗
│             D ────
└──────→ E ──────────→ G
聊天介面把它保存成時間序列。但你的思考,早就已經變成了一張圖。
AI 對話介面把 Graph 保存成了 Linear。
這是一個非常重要的結構損失。
而當你請 AI 把這場對話整理成文章,它做的事情是:把這張圖,再次壓成一份線性文件。
原始認知圖:
              ┌─ 概念 B
              │
問題 A ───────┼─ 概念 C ──→ 洞見 F
              │       ↘
              └─ 彎路 D ──→ E
壓縮之後的文章:
第一節
第二節
第三節
第四節
……
文章可能寫得很好,重要的概念也都有涵蓋。但是你作為原始探索者,失去了一個非常重要的能力:
「這篇文章,跟我兩個小時前走過的那張認知地圖,到底長得有多像?」
你沒有辦法確認。因為中間那張圖,從來沒有被保存下來。
📌 Graph 和 Linear 的差異,不只是形狀不同
線性文件(Linear)的閱讀方式是:從頭到尾,依序。你知道前面有什麼、後面有什麼,但你很難同時看到「A 和 D 之間的橫向關係」。
圖(Graph)的結構是:節點 + 連結。每個概念是一個節點,概念之間的關係是連結。你可以從任何一個節點出發,沿著連結走向任何方向,也可以同時看到多個節點之間的關係。
人類的思考,天然傾向圖的結構。但幾乎所有的文字表達工具,都只支援線性輸出。這個張力,從文字發明以來就存在,只是 AI 讓它變得更明顯。
三、問題不是「摘要寫得夠不夠好」
這裡有一個很容易走錯的方向。
當你覺得 AI 整理的文章「好像少了什麼」,直覺的解法是:要求 AI 寫更詳細、更完整、更長。
但這個方向是錯的。
更長的文章,不會解決「你沒辦法一眼確認它是不是你走過的那條路」這個問題。它只會讓線性掃描的成本更高。
真正缺少的,不是更多的內容,而是一個讓你可以「平行觀看」文章結構的導航層。
人類需要的未必是「把文章變短」。
而可能是「把文章的結構變得可以被人類平行觀看」。
這兩件事情完全不同。
一本書加上目錄,不是把書變短,而是讓你可以在不讀完的情況下,先掌握全貌。
AI 對話之後需要的,也是同樣的東西——只是這個東西,目前幾乎沒有工具在提供。
四、論點地圖,應該是長對話之後的標配
如果 YouTube 影片有時間軸,那麼一場 90 分鐘的 AI 討論,也應該有對應的導航層。
這個導航層,不應該只是「摘要:3,000 字」。
它應該至少同時產出一份論點地圖,長這樣:
【90 分鐘知識旅程】
起點
│
├── ① 問題定義
│
├── ② 第一個假設
│    │
│    ├── ③ 反例出現
│    │
│    └── ④ 延伸問題
│
├── ⑤ 跨領域連結
│
├── ⑥ AI A 的觀點
│       │
│       └── AI B 的反駁
│
├── ⑦ 人類修正假設
│
├── ⑧ 意外岔路 ★
│
└── ⑨ 最終洞見 ★
而且每一個節點都可以點回對應的原始討論位置:
「⑧ 意外岔路 ★」→ 原始討論 43:17~48:52
這才叫可回溯。
有了這張圖,你可以用 30 秒確認「對,就是今天走過的那條路」,再決定要不要深入某個節點。不用在兩個極端之間跳:
- 重新讀兩個小時的討論。
- 或者,相信 AI 的整理大致涵蓋了一切。
這兩個選項,都不是你真正想要的。
五、更進一步:文章也應該有「反向路程圖」
這裡還有一個更完整的想法值得提出來。
AI 把對話整理成文章之後,除了交付文章本身,還應該交付一份反向路程圖——說明原始討論的哪些節點,對應到文章的哪些段落:
原始討論 24 個節點
          │
          ▼
     ┌─────────┐
     │ 文章地圖 │
     └─────────┘
       │  │  │
       ▼  ▼  ▼
      §2  §4  §6
       │    │
       └────┼────→ §7
            │
            ▼
           §10
甚至,每個文章段落可以標示它的來源性質:
| 標記 | 意思 |
|---|---|
| 🟢 | 直接承接原始討論節點,幾乎沒有重組 |
| 🟡 | 多個節點融合成一段 |
| 🔵 | AI 重組後產生的新抽象,原始討論裡沒有這個說法 |
| ⚪ | 純粹的編輯銜接文字,沒有對應的原始節點 |
有了這個標記,你一眼就能知道:
「原來今天那 24 個節點,被壓成了 11 節。
§4 是 AI 重組出來的新抽象,原始討論沒有這樣說過。
§7 把三個不同時間點的節點融合在一起。」
這個瞬間非常重要。它讓你從「只能相信 AI 的整理」,變成「可以主動確認 AI 做了什麼決定」。
📌 這不是幻想,這是工程問題
Git 的 diff 視圖,讓你可以一眼看到「這個版本相對於上個版本,改了什麼」。Code review 工具讓審查者不必重讀整份程式碼,只看有變動的部分。這些都是「讓人類可以平行確認結構變動」的工具。
AI 文章整理,需要一個類似的機制——不是讓你重讀原始對話,而是讓你快速確認「AI 的整理,相對於原始討論,做了哪些結構性的決定」。技術上,這是可以做到的。目前沒有工具做這件事,只是因為沒有人把它當成必要功能去設計。
六、AI 的資訊存取方式,和人類根本不同
這裡有一個更底層的不對稱值得說清楚。
人類讀文章,通常是這樣的:
第 1 行
 ↓
第 2 行
 ↓
第 3 行
 ↓
……
AI 在內部處理文字,可以同時看到:
概念 A ─┐
概念 B ─┼─ 關聯
概念 C ─┤
概念 D ─┘
   ↓
整體語義與結構
AI 不是比人類讀得快,而是它的資訊存取方式,從根本上就不一樣。它可以在六秒內把一篇長文的結構平行載入,然後根據整體語義做判斷。
人類做不到這件事。人類需要靠外部工具——目錄、時間軸、論點地圖——來補償這個能力的缺口。
當 AI 整理出一份文章,它自己可以在幾秒內確認「這份文章跟原始討論的對應關係」。但人類拿到這份文章,面對的是一個全新的線性掃描任務,沒有任何導航工具。
AI 壓縮資訊的能力,和人類解壓縮資訊的能力,存在一個根本的不對稱。
填補這個不對稱的,應該是「可導航的拓撲結構」,不是更長的線性文字。
七、成熟的人機知識系統,應該有三個層次
把前面所有的東西整合起來,可以看到一個缺口:
現在我們通常只有兩個極端:
- 原始對話——完整,但沒有導航,線性掃描成本極高。
- AI 摘要文章——有導航(目錄),但已失去拓撲結構,無法確認對應關係。
缺少的,是中間那一層:
                    原始討論
                       │
             ┌─────────┴─────────┐
             ▼                   ▼
        線性紀錄              論點圖譜        ← 目前缺少這個
             │                   │
             ▼                   ▼
          摘要文章            知識地圖
             │                   │
             └─────────┬─────────┘
                       ▼
                  人類快速巡覽
                       │
                       ▼
                 需要時深入回看
三個層次各有分工:
| 層次 | 功能 | 目前狀態 |
|---|---|---|
| 摘要文章 | 壓縮內容,傳遞結論 | ✅ 有工具 |
| 論點圖譜 | 保留拓撲結構,讓人類可平行確認 | ❌ 幾乎沒有 |
| 原始對話 | 考古與驗證,追溯原始脈絡 | ✅ 有,但無導航 |
三者缺一不可。目前幾乎所有 AI 工具只提供第一和第三層,中間那層論點圖譜,基本上是靠使用者自己用紀律手動補。
八、把這三篇放在一起看
這篇文章是這個系列的第三篇。把三篇的核心論點放在一起,可以看到一條完整的脈絡:
| 篇 | 核心問題 | 核心論點 |
|---|---|---|
| 第一篇 | AI 在做什麼? | 壓縮本身是判斷,人類要守住取捨的主導權 |
| 第二篇 | 洞見去哪了? | 知識生成容易、回收困難,要有意識地把旅程留下來 |
| 第三篇 | 怎麼確認沒有丟掉? | 人類需要的不是更好的摘要,而是可導航的拓撲結構 |
這三個問題,其實是同一件事的三個層次:
壓縮之後,不只要留下內容,還要留下可導航的拓撲結構。
因為線性摘要保存的是「說了什麼」,論點地圖保存的是「我們怎麼走到這裡」。
後者,才是最容易在 AI 幫忙「整理得太漂亮」之後,被悄悄弄丟的東西。
九、目前能做什麼
理想的工具還不存在。但現在就可以做的事情,有幾個方向:
- 在長討論結束時,主動請 AI 產出論點地圖——不是摘要,而是一份節點清單加上節點之間的關係。這一步目前需要你主動要求,AI 不會自動做。
- 在請 AI 整理文章時,同時要求它標注每個段落的來源性質——哪些是直接承接原始討論,哪些是重組後的新抽象。這讓你可以快速確認哪些地方需要回頭核對。
- 把論點地圖和文章一起保存——不只存文章,也存那張圖。下次重新開啟這個主題,先看圖,再看文章,再決定要不要回去翻原始對話。
- 用雙向連結型的筆記工具輔助——Obsidian、Logseq 這類工具,可以讓你手動建立概念之間的連結,部分補償「AI 把圖壓成線性」這個損失。
這些都是當前條件下的 workaround,不是完整解法。完整解法需要工具層面的支援,而那個工具,目前還沒有人做出來。
但工程師的工作方式,向來是這樣:先把坑說清楚,才能設計繞法。知道中間缺了「論點圖譜」這一層,至少可以開始有意識地用手動方式去填補它——在更好的工具出現之前。
工程師思路系列 · 第四章
「雨停了。」——知識重建的統一模型
作者不是把資訊搬給讀者,而是提供一組足以讓讀者重新建構某個東西的線索。
這句話看起來在談文學。但它同時也在說論文、說 AI,說所有知識傳遞的底層結構——包括工程師在現場留下的那些記錄。
一、「覆現」這件事有多深?
有些作家厲害到可以在紙上覆現:味道、聽覺、視覺、觸覺。
不是用說的,而是讓你真的感覺到。
作者沒辦法把氣味裝進書頁裡,沒辦法讓紙張發出聲音,也沒辦法控制你讀書時的溫度。但某些句子讀完之後,你確實會「聞到」那個地方,「聽見」那個聲音,甚至感覺到皮膚上的冷。
這個現象值得認真問一次:它的機制是什麼?
先把「覆現」這個詞放下來看。「覆現」容易讓人以為:
作者的 A → 讀者得到 A',而且 A' ≈ A
但實際的閱讀過程更接近:
作者的經驗 A
  ↓ 編碼(寫作)
文字線索 B
  ↓ 解碼(閱讀)
讀者甲的重建 A₁'
讀者乙的重建 A₂'
讀者丙的重建 A₃'
A₁’、A₂’、A₃’ 不會完全相同,也不必然等於 A。每個讀者用自己的記憶、感知、背景知識來解碼,得到的是屬於自己的重建版本。
這就是為什麼同一本書,不同人會讀出不同的世界;同一本書,十歲讀和三十歲讀感覺也不一樣——不是書變了,而是你用來解碼的材料變厚了。
「覆現」不夠精確。更接近的說法是「重建(reconstruct)」——不是複製,是再生。
二、論文留下的是什麼
先從論文說起,因為它的目的比文學更明確。
一篇好的論文,不只是讓讀者理解作者怎麼想。它更重要的目標是讓另一個研究者能夠:
- 檢查推理過程是否有漏洞
- 理解每個決策背後的依據
- 批判假設是否成立
- 在條件允許時,重現相近的結果
所以論文試圖留下的,是一條「可檢查、可重建的知識生成路徑」。這跟「讓讀者理解作者怎麼想」有交集,但不完全相同——科學上的可重現性,要求的是結果能被獨立驗證,而不只是推理能被理解。
這也是為什麼方法、資料、實驗條件、引用、定義這些東西在論文裡如此重要:它們是讓別人能夠重建、驗證你的知識的必要條件。少了這些,論文就退化成一份說法,而不是知識。
三、文學在做的是完全不同的事
作家不一定告訴你「這杯茶是 72°C」。他可能寫:
「第一口碰到舌尖時,還有一點燙,吞下去後,喉嚨留下淡淡的澀。」
這時候作者不是在傳遞「茶的資料」,而是在嘗試讓你的大腦重新經歷一次那個感覺。
厲害的作家可以觸發:味覺、聽覺、視覺、觸覺、嗅覺、溫度感、重量感、時間感——甚至是身體的疲憊、心跳加速、胃部緊縮。
文學覆現的,是感知與經驗。不是資料,是經驗本身。
但這裡需要加一個重要的說明:文字並不是把「高維原始資料」無損壓縮成較小的檔案。它比較像一種有損、選擇性、依賴上下文的編碼。
作者沒有寫「房間濕度 83%、溫度 24.7°C」,而是寫:
「窗戶上全是水氣。」
讀者從這句話自行推導:潮濕、悶熱、下雨、室內外溫差……作者不是保存了所有資訊,而是選擇了:哪些資訊值得留下,足以讓讀者完成重建?
這比「壓縮」更接近「篩選」——一個主動的、帶有判斷的過程。
四、兩者的統一結構
論文和文學,留下的東西不同,但底層結構是一樣的。
作者原本擁有的,是一個非常高維度的內在狀態。以一個具體的例子來說:
「我在 1987 年夏天的某一天,走進一間老房子。」
這個經驗包含幾百、幾千個訊號:光線、氣味、聲音、溫度、家具、空間、人的表情、當時的心情、過去的記憶、身體感覺……
作者不可能把全部原始訊號傳給讀者。他必須選擇——哪些線索值得留下,足以讓讀者的大腦在接收後,啟動一次足夠接近的重建。
整個結構是:
作者的高維度內在狀態
  ↓ 選擇性編碼(寫作)
文字(低維度的線索集合)
  ↓ 傳輸(出版、閱讀)
讀者接收文字
  ↓ 解碼(腦中重建)
讀者的重建版本(因人而異)
論文和文學走的是同一條路,只是編碼的對象不同:論文編碼推理路徑,文學編碼感知經驗。
五、「雨停了。」
這裡有一個非常極端的例子。
「雨停了。」
只有三個字,資訊量非常少。
但如果作者在前面已經建立好整個場景——雨中的街道、等待的人、壓抑的氣氛——這三個字可能讓讀者自行補出:雨聲消失、屋簷還在滴水、地面開始反光、泥土氣味出來、遠處有人走動、天色慢慢亮起來,以及人物情緒的某種轉變。
注意:這些不是作者告訴你的。是你自己的大腦,根據前文建立的場景,主動補出來的。
作者只給了一個觸發點。你完成了剩下的世界。
越好的作品,未必資訊量越大。
反而可能是:文字量↓,讀者腦中重建的東西↑。
這也解釋了為什麼有些作品用很少的字卻讓人久久無法忘記,而有些作品寫了幾十萬字卻讓人讀完即忘——後者提供的是資訊,前者提供的是觸發重建的線索。
📌 這就是為什麼場景建立這麼重要
「雨停了」這三個字能觸發多少重建,完全取決於前文建立的場景有多充分。沒有前文的鋪陳,「雨停了」就只是氣象資訊。有了足夠的前文,它才變成一個爆炸點。這也是為什麼作家在乎「前置鋪陳」,工程師在乎「前提說明」,研究者在乎「文獻回顧」——它們都在做同一件事:替讀者的解碼器安裝必要的背景模型。
六、目錄、摘要、時間軸——都是同一件事
人類在閱讀或消化一個長作品時,最大的問題之一不是「資訊不足」,而是「我不知道怎麼定位」。
所以我們發明了各種工具,讓讀者能更有效率地啟動重建:
| 工具 | 對應的結構 | 讓讀者能做什麼 |
|---|---|---|
| 目錄 | 節點索引 | 快速定位,不必線性掃描 |
| 路程圖 | 關係結構 | 一眼看到全文脈絡,知道各部分的關係 |
| 摘要 | 局部壓縮 | 快速掌握結論,決定要不要深入 |
| YouTube 時間軸 | 事件節點 | 直接跳到感興趣的段落 |
| 論文 | 可重建的知識生成路徑 | 重新走一次推理過程,驗證結論 |
| 小說 | 可重建的感知模型 | 重新經歷作者想傳遞的感知與情感 |
把這張表用另一種語言說:
文字     = 節點與線索
目錄     = 節點索引
路程圖   = 關係結構
摘要     = 局部壓縮
全文     = 完整可重建路徑
讀者     = 解碼器
背景知識 = 解碼器的既有模型
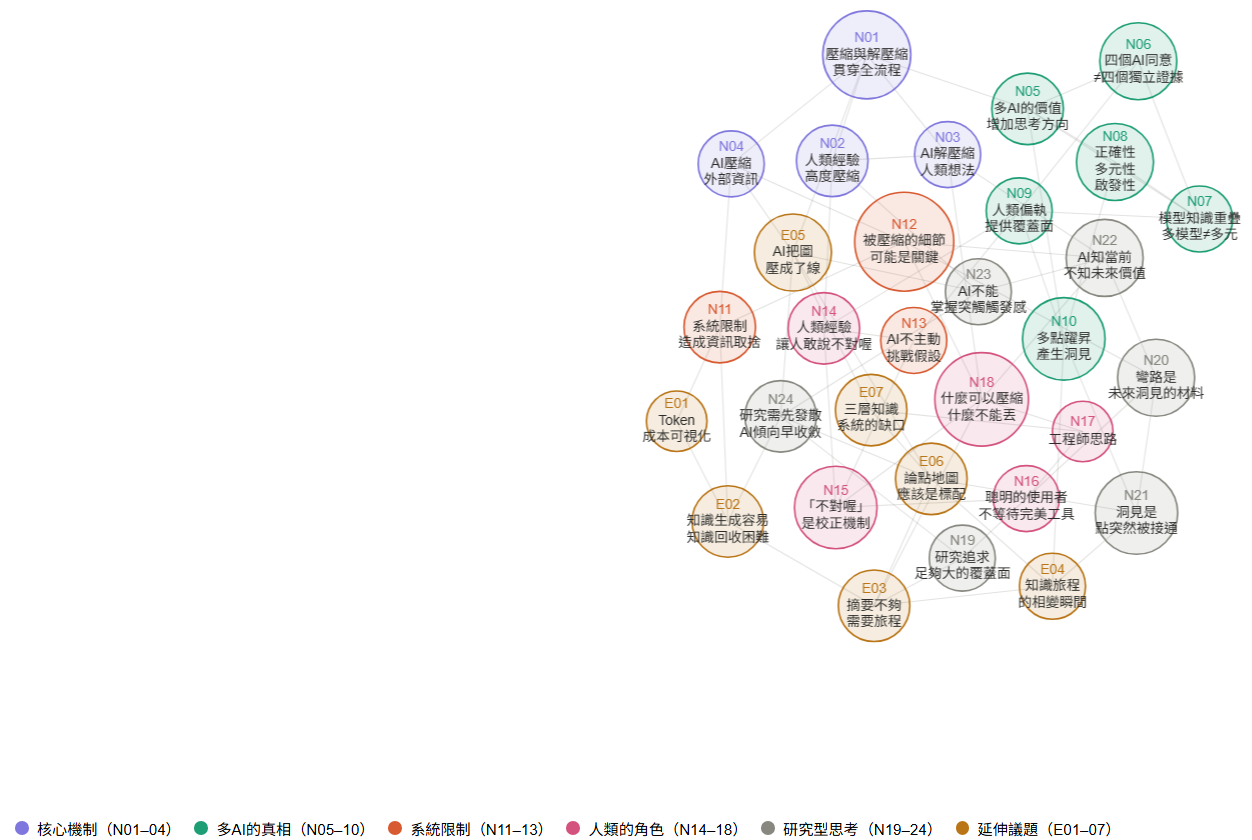
這樣一來,前幾篇文章裡談過的「論點地圖」和「圖論」就不是另一個主題了。它們是同一個問題的具體回答:如何讓人更有效率地完成知識重建。
七、AI 壓縮真正危險的地方,不是資訊遺失
說到這裡,可以回到 AI 的問題,而且這次可以說得更精準。
AI 摘要真正危險的地方,不一定是「少了資訊」。
而可能是:少掉了讓人能夠重新建立因果關係的線索。
舉一個具體的例子。原始討論的路徑是:
A → B → C → D → 意外發現 X → 回頭重新理解 A
AI 整理後的摘要可能變成:
A → B → C → X
看起來更乾淨,更有效率。
但真正珍貴的東西消失了:
「為什麼會突然想到 X?」
「X 是在什麼條件下冒出來的?」
「為什麼有了 X 之後,A 的理解會改變?」
這不是單純的資訊遺失。而是重建路徑被破壞。
讀者拿到這份摘要,可以理解結論 X,但沒有辦法重走一遍「為什麼 X 是對的」這條路。更沒有辦法在下次遇到類似情況時,用同樣的思路找到屬於自己的 Y。
這個問題,比「AI 偶爾會幻覺」更值得長期關注。因為幻覺是偶發的,重建路徑被破壞是系統性的。
📌 「意外發現 X」為什麼特別重要?
在研究和工程工作裡,最有價值的洞見,往往不是沿著預期路徑走到的結論,而是在走錯路、繞路、遇到矛盾的過程中突然冒出來的東西。這種「意外的 X」,它的觸發條件非常脆弱——移走前面的某一個彎路,X 可能就不會出現。AI 整理時傾向保留結論、省略過程,恰好會把這種最有價值的東西最先丟掉。
八、知識的價值,不只是答案被保存
把這整個討論推到最後的地方。
最頂尖的作者,能讓你重建一個你從來沒有親身經歷過的世界。不是傳遞關於那個世界的資訊,而是讓你的大腦真實地經歷它——感覺到那裡的溫度,聽見那裡的聲音,理解那裡的人為什麼做出那樣的選擇。
這已經不只是傳遞資訊了。
這是某種「經驗的跨人傳輸」。
而這個能力——用最少的線索,觸發最完整的重建——不管是在文學、論文、還是工程現場的文件裡,都是同樣重要的核心能力。
這也是 PCPiLOT 一直在做的事情的本質:
好的知識系統,不只是儲存答案。
而是保存讓下一個人能重新走到這個答案所需要的最小充分線索。
下一個工程師即使沒有經歷過這件事,也能沿著留下來的線索,重新建立判斷。這跟「把學費留下來」幾乎是同一件事情。
所以知識的價值,不只是答案被保存。
而是判斷能不能被重新建構。
作家花幾年磨一本書,精心選擇每一個細節,是為了讓讀者的大腦能夠正確解碼。AI 在幾秒內完成整理,卻未必知道哪些細節是讓人能夠重建判斷的關鍵。
這就是為什麼,AI 做的壓縮,不能完全外包給 AI 決定。
判斷哪些線索值得留下——這件事,目前還是人類的工作。
τ
Mr. τ
風雲網通系統有限公司 PCPiLOT · 工程師思路系列
#AI助理 #LLM #知識壓縮 #知識回收 #圖論 #知識重建 #工程師思路 #知識工程 #PCPiLOT
Comments