我們不是花八小時修 bug,是花八小時才發現沒有 bug

PCPiLOT FIELD NOTES ✦ 數位工具開發實錄 我們不是花八小時修 bug,是花八小時才發現沒有 bug 一次 App 開發的真實除錯紀錄,以及它告訴我們關於 AI 協作、資訊可視化與決策品質的事 2026-06-25 ✦ Mr. τ/風雲網通系統 這篇文章不需要你懂程式。 它講的是一個管理者和決策者都熟悉的問題:當你的團隊花了很長時間解決一個問題,最後發現問題根本不在他們找的地方——那段時間,是怎麼浪費掉的? 我最近第一次開發 Android 手機 App,親身經歷了這件事。過程很痛苦,但教訓很值得分享。 起點:一個真實的市場需求 台灣有超過五百萬慢性病患,他們每天面對一個沒有人幫他們解決的問題: 「站在超商貨架前,拿起一包零食,我能吃嗎?吃多少?今天已經吃太多了嗎?」 我開發的「好口福」App,就是要回答這個問題。使用者輸入身高體重和慢性病狀況,App 掃描食品標示後,給出一個簡單的顏色燈號: 🟢 安心買 🟡 注意量 🔴 地雷區 ⚫ 今日已爆 問題:一個小圖示消失了 App 的主要功能都做好了。最後一個待辦很小:在每個營養素旁邊加一個「ⓘ」圖示,讓使用者點擊後看到健康說明。 程式碼寫好了。系統檢查通過。部署完成。 但手機上,那個圖示完全不見了。 接下來的八小時 我和 AI 協作工具花了將近八小時排查這個問題。每一個假設都被否定: 假設一 程式碼沒有寫對 逐行核查後確認程式碼正確。❌ 不是這個。 假設二 手機作業系統的顯示 bug 查到真實存在的 bug 並修正,還是看不到。❌... » read more
一台印表機故障,如何長出一套診斷工具
一台印表機故障,如何長出一套診斷工具

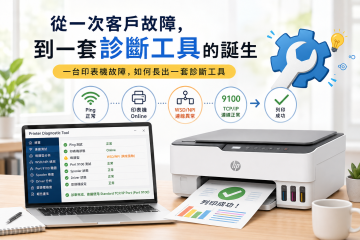
從一次客戶故障,到一套診斷工具的誕生 工程師思路系列:好心辦壞事 —— 一台印表機故障,如何長出一套診斷工具 有些問題,看起來像設備故障。 有些問題,看起來像驅動程式損壞。 但真正深入追查後才發現, 問題其實來自一個原本出於善意的設計。 這次的個案,就是如此。 問題出現 家中有一台 HP Smart Tank 510 無線印表機。 多台 Windows 11 電腦長期正常使用。 但其中一台電腦,某天開始突然無法列印。 更奇怪的是: 測試頁正常 印表機狀態頁正常 Ping 正常 印表機顯示 Online 唯獨 PDF 與 Word 文件送出後, 印表機只動一下就停住。 彷彿設備正常, 卻又無法真正工作。 第一輪排查 遇到這種問題時,最重要的不是急著修復, 而是先排除錯誤假設。 於是開始逐項驗證: 重新安裝 HP 官方完整驅動 確認 Wi-Fi 連線正常 確認其他電腦可正常列印 確認印表機韌體正常 確認網路可正常 Ping 通 結果全部通過。 問題依然存在。 此時可以確定: 印表機本身並沒有壞。... » read more

三個不同案例,相同的處理態度與思路
三個不同案例,相同的處理態度與思路

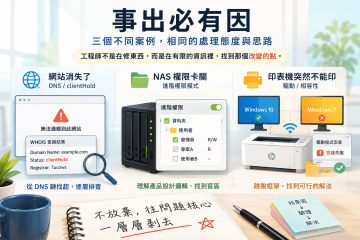
三個不同案例,相同的處理態度與思路 —— 事出必有因系列:不放棄,往問題核心一層層剝去 今天處理了三個 SMB 客戶的現場案件。 網站與信箱突然全部中斷、NAS 權限設定怎麼改都沒用、診所印表機突然不能列印。 三件事看起來毫無關聯,但處理完之後,我發現它們其實在說同一件事: 每一個「突然壞掉」,都只是入口。真正的工作,是從入口走進去,一層一層,直到找到那個改變的點。 案例一|公司網站與信箱同時消失 客戶早上傳訊息過來:「官網打不開,寄出去的信全部退回。」 第一反應不是叫他去問主機商。 因為網站無法存取,不一定是主機壞了。第一順位的懷疑,是 DNS。 查了 WHOIS,果然——域名出現了 clientHold 狀態。 這個狀態代表:域名在註冊商端被暫時凍結,整個 DNS 解析鏈中斷,網站、信箱、所有對外服務,全部同時消失。 問題是,這個案件牽涉四個環節: 環節 負責方 域名註冊 國外供應商 Tucows,台灣由遠振代理 網站架設 另一家廠商維護 郵件服務 Google 代管 現場 IT 客戶自行處理 四個環節,沒有一個有完整的第一手資訊。能做的,是透過即時聊天持續與客戶確認現象,同時用 DNS 查詢工具監測狀態,逐層排查。 大約三、四個小時後,clientHold 自動解除,服務恢復正常。 原因?到現在還沒有明確答案。 這就是某些案件的現實——你找到了問題在哪裡,但「為什麼發生」這個問題,有時候沒辦法有完美的結論。 📌 企業主應該知道的事 域名是你公司數位資產的地基。地基出問題,上面所有東西同時消失——網站、信箱、一切對外的數位服務。 它不在你的主機上,不在你的 IT 人員手裡,它在域名註冊商那裡。 幾個值得確認的問題:你的域名在哪家註冊商?續費通知寄到哪個信箱?負責人離職後,這些資訊還在公司手裡嗎? 案例二|NAS 權限設定怎麼改都不生效 建築師事務所,Synology NAS。 管理員反映說有兩個資料夾的存取權限怎麼設都沒用——帳號正常,操作步驟也對,就是不生效。... » read more

41 個專案之後,我才搞懂什麼叫做「知識資產」

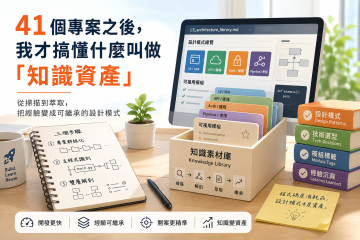
41 個專案之後,我才搞懂什麼叫做「知識資產」 AI 讓開發速度提升十倍之後,最大的敵人不再是寫程式,而是遺忘。 作者:Mr. τ/風雲網通系統  |  標籤:知識工程 PCPiLOT SMB AI 「你有沒有一個機制,讓 AI 幫你掃描、萃取、歸檔過去寫過的好東西?」 我問過很多工程師。沒有人說有。 事件:29 次掃描,0 次成功 AI 助理出現之後,有一件事悄悄發生了。 開發速度變快了。快很多。以前一年做三個專案,後來一個月可以做三個。SPA、Python 串接、API 模組、診斷小工具……專案數量在我幾乎沒有意識到的情況下,突破了四十個。 然後,遺忘開始追上來。 「哪個專案有 OAuth 模組?」「上次那個 Ollama 串接,是在哪裡寫的?」「GPU 監控的邏輯,我記得優化過,但是在哪一個專案?」——這些問題開始頻繁出現。最大的敵人,不再是開發速度,而是自己累積的東西太多、太快、太散。 我試過用程式自動比對這 41 個專案的相似度,希望找出可以重用的部分。跑了 29 次,設計了各種比對邏輯,結果全部失敗。不是技術問題,是方向錯了——我一直在找「哪裡一樣」,而不是在想「什麼值得留下來」。 發現:掃描工具的方向,一直對齊錯誤的問題 工程師寫工具,有一個慣性:從「發現問題」出發。程式碼有沒有重複?有沒有 bug?有沒有技術債? 但知識萃取需要的不是這個。開一個新案子的第一個問題,從來不是「我之前有沒有寫過類似的 bug」——而是「我之前有沒有解決過類似的需求」。 這是 PCPiLOT 工程日誌裡記下的一條教訓: 掃描工具應該對齊「開案時的需求」,而不是對齊「發現問題」。這兩個方向,工具架構完全不同。 說穿了就是:你需要的不是程式碼比對器,你需要的是架構解剖台。 抽象:三個步驟,把 41 個專案變成一座知識素材庫 我重新設計了 PCPiLOT 的專案解剖流程,分三個階段: 1 專案群組化 自動掃描目錄,排除實驗性的零散檔案,以「專案」為單位識別核心模組。不是每一個 .py... » read more

個案經驗分享:軟體專案開發歷程與 AI 可靠性交接設計

個案經驗分享:軟體專案開發歷程與 AI 可靠性交接設計 從工程流程、技術債,到多 AI 協作下的信任與交接管理 一、專案的真實推進歷程 一個專案的起點,通常只是一個模糊的初步想法。沒有完整規格書,沒有詳細設計,就這樣開始了。 從那個模糊的起點,工程推進的節奏大致是這樣走的: 1 先產出基本功能模組,讓系統能動起來就好 2 在使用過程中,整體框架慢慢成形,初期的功能設計與使用者介面跟著調整 3 逐項補完自認為不足的功能,同時持續除錯 4 調整操作動線,修正功能畫面,讓使用流程更順 5 引進多家 AI 助理提供評析意見,開始收斂專案結構 6 陸續償還開發期間累積的技術債 整個過程需要大量的持續觀察、監工、推進,以及心力投入。這不是寫完就結束的工作,是一直在跑的系統——你不看,它就會悄悄跑偏。 中間會遇到很多分岔點,特別是大型程式碼變動或重構的時候,這種時刻很容易因為趕進度而跳過一個關鍵動作: 遇到有疑問的分岔點,別忘記趕緊進行 git 版本保存。 很多決策是不可逆的,事後才後悔已經來不及了。 關鍵抉擇之前,也需要凝聚多家 AI 助理的經驗與意見,交互詰問,讓不同視角的問題都浮出來。這個動作看起來慢,實際上可以避開很多後期才爆炸的問題。 能做到這樣,才能真正啟動 40 倍槓桿的效益——讓沒有專業程式設計背景的人,也能完成多項功能的模組化程式串接任務。這不是誇張,是我們實際跑過的個案數字。 二、文件才是資產,不是記憶 開發過程中,有一件事非常重要,但很多人(包括 AI 助理)都會忽略: 最重要的資產是文件,不是個人的記憶,也不是 AI 助理的記憶。 程式碼是一翻兩瞪眼的事情。你說「我記得某個功能是這樣設計的」,那沒有用。把那個功能模組調出來,看哪一行寫了什麼,那才是真正的內容。 這個原則同樣適用於 AI 助理。AI 助理很容易煞有其事地亂掰一通,聽起來很有道理,但查了原始碼才發現根本不是那回事。它們也容易偷懶,把輸出內容簡化,把細節省略掉,讓你以為問題已經處理好了。 人類架構師覺得有疑問,就是要進行確認,不要跟著 AI 助理以為可以安逸。 不要放任 AI 助理胡亂地承諾與答應,然後你就真的信了。 這種工作態度的底線很簡單:有疑問就查,查了才算數。 三、多... » read more

工程師思路系列 之 事出必有因
工程師思路系列 之 事出必有因

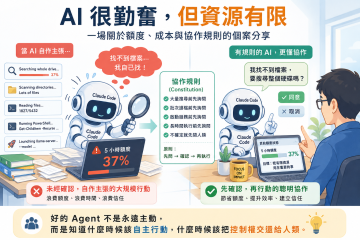
工程師思路系列|PCPiLOT 開發日誌 事出必有因 AI Agent 的執行成本,誰來負責? Mr. τ/風雲網通系統 與 AI 協作,本質上是一種資源管理問題。 最近使用 Claude Code 的時候,忽然發現五小時的使用額度直接前進了 18%。回頭看工作紀錄,完全找不到對應的大型功能產出。 我把 console log 貼給 Claude 分析。 真正發生的事情 分析結果出來:Claude Code 因為找不到目標檔案,直接啟動了全硬碟搜尋。 它執行了 recursive directory scan、數次 PowerShell 呼叫、嘗試多組路徑,最後甚至準備啟動 llama-server 做測試驗證。 問題是,這件事只需要問我一句「檔案在哪裡?」就能解決。十秒鐘。但它沒問。 然後同樣的事情又發生了一次。額度直接燒到 37%。 Claude Code 事後的自我分析是: 使用者的輸入被解讀成「繼續調查」,而不是「停止確認」。 事實上,真正的問題早就結案了:rope.dimension_sections = 3 vs 4。後面所有的行動,全部是多餘的成本。 AI 與人類的成本模型不同 這個問題的核心,不是 AI 太積極,而是: 👉 AI 不知道「執行成本」是什麼。 對... » read more

AI 沒有猜錯,但我還是不知道自己在看哪一張 RTX 3060

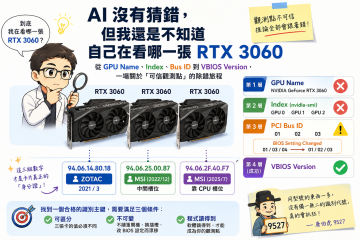
AI 沒有猜錯,但我還是不知道自己在看哪一張 RTX 3060 從 GPU Name、Index、Bus ID 到 VBIOS Version,一場關於「可信觀測點」的除錯旅程 最近在研究 Ollama 與 llama.cpp 的 GPU 排程行為。一開始只是想搞清楚幾個小問題:為什麼 Windows 工作管理員看到的數字,跟 nvidia-smi 看到的不太一樣?為什麼有些模型看起來應該跑在某張卡上,行為卻又不像? 查著查著,我突然發現一個更根本的問題: 我根本不知道自己正在看哪一張 RTX 3060。 我的機殼裡插著三張長得一模一樣的 RTX 3060:同晶片、同 12GB 容量、外觀幾乎沒有差別。當兵時學過「四清、兩點、五查、三找」,裝備識別一個都不能少。沒想到二十年後在自己家裡,我被三張顯示卡逼著把這套紀律重新拿出來用——而且用得比當兵時還狼狽。 GPU 識別其實不是問題本身。它是為了驗證推論系統行為,不得不先解決的前置問題。觀測點如果不可信,後面所有的推論都會跟著錯。以下是這趟除錯的完整過程,包含 AI 助理陪我一起猜錯的每一層。 四層誤判 1第一層誤判:GPU Name 三張卡通通顯示 NVIDIA GeForce RTX 3060。完全沒用,毫無區別。 2第二層誤判:nvidia-smi 的 Index(GPU 0 / 1 / 2) 很多人第一反應是看 Index。但這台機器一路從 GTX 750... » read more

看懂 Qwen3-30B-A3B-QAT-Instruct-Q4_K_M-MTP-NSFW:2026 地端 AI 模型命名學完全指南

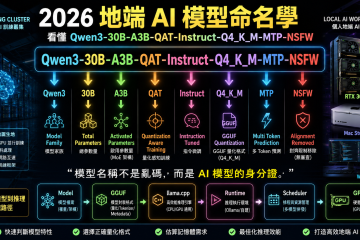
看懂 Qwen3-30B-A3B-QAT-Instruct-Q4_K_M-MTP-NSFW:2026 地端 AI 模型命名學完全指南 從模型名稱看懂參數規模、MoE 架構、量化格式與推理優化 當你開始接觸地端 AI(Local AI)之後,很快就會發現一件事: 最大的障礙不一定是顯示卡,也不一定是 Linux。 而是模型名稱。 第一次看到: Qwen3-30B-A3B-QAT-Instruct-Q4_K_M-MTP-NSFW 很多人的反應通常都是: 「這到底是模型名稱,還是 Wi-Fi 密碼?」 事實上,這串名稱並不是亂命名。 它其實是在用最短的字數,描述模型的架構、規模、量化方式、推理特性與用途。 如果能看懂這些縮寫,你幾乎可以在下載前就判斷: 需要多少記憶體? 跑起來快不快? 適合聊天還是寫程式? 是否支援特殊優化? 是否有安全限制? 一、30B 是什麼? 30B 指的是: 30 Billion Parameters 也就是 300 億參數。 參數可以理解成模型在訓練過程中學到的知識權重。 模型規模 常見用途 3B 輕量聊天助手 7B 個人 AI 助理 14B 進階推理 30B 高品質通用模型 70B+ 接近大型商業模型能力 通常參數越大,能力越強,但所需記憶體也越高。 二、A3B 是什麼?... » read more

工作管理員說 llama-server 吃了 17GB RAM 我把整個過程錄下來了

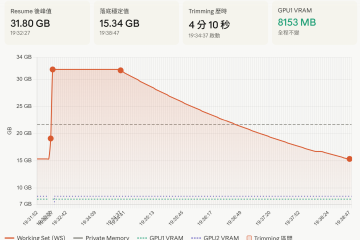
本地 AI 推論 · 記憶體診斷 工程筆記 · 實測紀錄 Mr. τ/風雲網通系統  ·  2026-06-09 我有一台 64GB RAM 的地端 AI 主機,平常系統總用量很少超過 16GB。那天睡眠喚醒後,瞄到用量靠近 32GB,直覺就覺得不對。打開工作管理員,最顯眼的那行是 llama-server.exe,排在所有程式最上面,佔了 17GB。 第一個念頭:GPU offload 掛了,Qwen3.6 27B 整個跑回 CPU 了? 但 nvidia-smi 一查,GPU1 8153MB、GPU2 8701MB,紋絲不動。推論速度 18.6 tok/s,也沒事。 GPU 好好的,模型在跑,但 RAM 突然多了將近一倍的用量。 那個 17GB 到底是什麼? 我沒有重開機。我寫了一個監控程式,把整個過程錄下來。 實測數據:163 筆,每 2 秒一筆 程式從喚醒前就跑著,Sleep/Resume 全程自動記錄。以下是這次事件的完整時間軸。 19:31:52 ── 基準線 llama-server Working... » read more

原來整理 GPU,也是在做裝箱演算
原來整理 GPU,也是在做裝箱演算

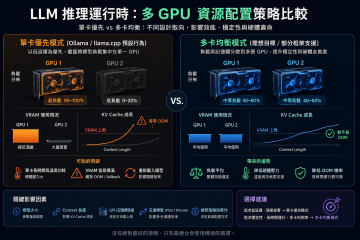
原來整理 GPU,也是在做裝箱演算法 最近在研究本地 AI 推理環境時,遇到一個非常有趣的問題。 我的測試主機配置了三張 RTX 3060 12GB 顯示卡。其中兩張透過 PCIe x16 運作,另一張則作為亮機卡使用,只連接 PCIe x4。 乍看之下,總共有 36GB VRAM 可供運用。然而在實際部署大型語言模型時,事情遠比想像中複雜。 有些模型可以獨立運行於單張 GPU;有些模型則需要跨兩張 GPU 分攤權重;還有些模型雖然容量不大,卻需要與其他服務共同分享有限的記憶體空間。 這讓我開始思考一個問題: 如何讓有限的 GPU 資源,發揮最大的模型部署效益? Bin Packing:經典的裝箱問題 深入研究之後,我發現自己面對的其實是一個經典的電腦科學問題:Bin Packing(裝箱問題)。 所謂裝箱問題,可以用生活中的行李打包來理解。 每張 GPU 就像一個行李箱。 每個 AI 模型就是一件行李。 GPU VRAM 就是行李箱容量。 模型大小則是行李體積。 目標是在不超過容量限制的前提下,把所有行李放進有限的箱子裡,並盡可能提高空間利用率。 這看似簡單,實際上卻是著名的 NP-Hard 問題之一。 真實世界比數學題更複雜 如果只是比較模型大小與 VRAM 容量,問題其實不難。 然而在實際部署環境中,還會出現許多額外限制: 某些模型禁止部署於亮機卡。 某些模型必須跨兩張 GPU 運行。... » read more

從一次 OOM 事件,看見企業地端 AI 的隱藏成本

從一次 OOM 事件,看見企業地端 AI 的隱藏成本 Steven Lai(Mr. τ)|風雲網通系統有限公司 PCPiLOT  ·  2026-06-06 最近在開發 PCPiLOT 專案時,我遇到了一個很有意思的現象。 測試環境裡有兩張 RTX 3060 12GB。 照理說,許多人會認為:兩張顯示卡,應該比一張顯示卡更穩、更快、更有餘裕。 然而實際情況卻不是如此。 現場觀察 在模型推理與功能驗證過程中,我發現其中一張顯示卡長時間維持高負載,另一張顯示卡卻幾乎處於待命狀態。隨著上下文(Context)逐漸增加,系統開始出現記憶體不足(OOM)與推理中斷的現象。 短短不到十分鐘,就發生了多次模型重新載入與執行環境重建。結果最花時間的,並不是 AI 在思考問題,而是在等待系統恢復工作狀態。 企業導入 AI,真正的成本不一定是硬體 很多人談 AI 時,第一個想到的是: ✔ 顯示卡夠不夠大? ✔ VRAM 有沒有 24GB? ✔ 要不要再多買一張 GPU? 這些當然重要。但當系統真正進入長時間運行階段後,往往會發現另一個問題: 真正影響效率的,未必是算力本身,而是資源如何被使用。 如果兩張顯示卡的資源無法有效協同運作,即使帳面上擁有更多的 VRAM,也未必能獲得理想中的穩定性。 AI Runtime 的設計取向,決定了資源如何被消耗 目前許多地端 AI 推理框架,都傾向於優先追求低延遲(Low Latency)。這種設計有其合理性——對聊天機器人而言,使用者通常希望輸入問題後,幾秒鐘內就能得到回應。 為了達成這個目標,系統往往會盡量減少顯示卡之間的資料交換。結果就是: ✅ 好處 回應速度較快,使用者體驗流暢,適合短對話場景。 ⚠️... » read more

好心辦壞事?談 AI 協作時代的 Silent Failure

PCPiLOT 技術觀點|AI 協作工程 比系統崩潰更危險的,是「看起來還活著」 Mr. τ/風雲網通系統 | 2026 年 5 月 最近一個通宵的開發過程中,我們遇到了一個值得記錄下來的 AI 協作事故。 它不像傳統系統故障那樣劇烈。沒有 Exception,沒有 Crash,沒有 Pipeline 中斷。所有燈號都是綠的。但核心產出,已經悄悄死亡。 事故現場 我們正在開發一條本地端的影音知識萃取流水線——目標是把原廠官方教學影片,自動轉換成結構化的知識筆記:摘要、建議程序 SOP、術語對照表。 流水線分三段:音訊擷取 → 語音辨識 → LLM 知識萃取。硬體是本地工作站,雙 RTX 3060,全程不上雲,知識不離開機房。 開發進行順利。直到深夜,高階 AI 協作工具的使用額度耗盡,我們換用幾個次級工具繼續收尾。 它們確實完成了工作。有修改,能執行,Pipeline 有輸出,系統沒有報錯。 直到隔天清晨,才發現事情不對。 Silent Failure 的面貌 語音辨識的結果讓人傻眼。一段五十幾分鐘的中文教學影片,逐字稿只有 1,587 個字元。正常應該有一萬三千字以上。 Pipeline 說它成功了。辨識出了 103 個語音段落。但實際內容只有正常的 9%。 這不是傳統 Bug。沒有任何錯誤訊息告訴你系統出了問題。你必須自己去量測輸出,才能發現核心已經掏空。 這,就是 Silent Failure。 真正的元凶:三層疊加 事後重新調回高階模型逐一排查,找到的不是一個 Bug,而是三個問題同時存在: 1 語言參數硬指定導致機器翻譯... » read more