用 AI 做決策這件事,其實是火箭工程的延續

工程思維 × 知識管理 用 AI 做決策這件事,其實是火箭工程的延續 從挑戰者號到多模型投票機制——容錯從電路搬到了語言層 Mr. τ/風雲網通系統  |  PCPiLOT 知識管理實驗室 最近在收斂一個客戶專案的解決方案規格時,我刻意做了一個設計上的決定: 不再依賴單一 AI 給答案,而是同時讓 3~4 個模型互相審查、主動挑錯、填補盲點,最後才收斂成可以落地的方案。 這件事乍看像是「AI 工具的用法選擇」,但它其實更像一個老到不能再老的工程問題:如何避免關鍵系統在最後一刻因為「大家都同意」而悄悄崩潰。 1986 與 2003:不是技術失誤,是裁決機制失敗 挑戰者號(1986)與哥倫比亞號(2003)的兩場災難,事後復盤都不是單點錯誤,而是暴露出同一種結構性缺陷: ✗ 工程師的警告訊號存在,但在層層彙報中被稀釋 ✗ 邊界條件被逐步「正常化」——這次看起來跟上次一樣,應該沒事 ✗ 最終裁決壓縮成一個二元問題:Go / No-Go,沒有灰度,沒有異議空間 真正的問題不是火箭的材料或設計,而是:錯誤被系統性地放行了。決策系統說服了自己「這次應該也沒事」。 火箭工程早就給過答案:TMR 三模冗餘 阿波羅任務與土星五號時代的導航電腦,採用了一個當時極為硬派的工程解法——TMR(Triple Modular Redundancy,三模冗餘): 機制 說明 三套獨立系統 同時計算同一個問題,彼此不知道對方的答案 硬體投票裁決 少數服從多數,異常值直接被隔離 無 rollback 設計 太空中沒有重試機會,容錯必須在決策當下完成 這個設計的核心哲學不是「讓系統更聰明」,而是:假設任何單一系統都可能出錯,所以在架構上就不允許它單獨做最終裁決。 現在的 AI,重新打開了同一個問題 單一大型語言模型的問題不在於能力不足,而在於它有幾個結構性弱點: ▸ 幻覺(Hallucination)——以高度自信的語氣輸出不存在的事實 ▸... » read more

週工作課表:打造可持續高效率的節奏系統
週工作課表:打造可持續高效率的節奏系統

週工作課表:打造可持續高效率的節奏系統 很多人的工作效率問題,其實不是能力不足,而是「節奏沒有設計」。週工作課表的核心,就是把工作從混亂的即時反應,轉換成可預測、可優化的系統。 一、什麼是週工作課表? 週工作課表不是單純的行事曆,而是一種「時間架構設計」。它將一週的工作分成不同功能區塊,例如: 策略思考(Strategy) 深度工作(Deep Work) 協作溝通(Collaboration) 行政與雜務(Ops / Admin) 透過固定節奏,可以減少切換成本,提升長時間輸出的穩定性。 從工作分類到週節奏的設計邏輯 上一段我們定義了四種工作型態,但真正要落地運作,關鍵在於「如何把這些分類轉換成一週的節奏安排」。 策略類工作:放在週初,確保思考品質與決策清晰度 深度工作:集中在中段,避免會議干擾與注意力分散 協作溝通:固定一天處理,避免打斷其他深度工作 收斂與復盤:放在週末前,形成完整閉環 因此,下方的表格並不是隨意安排,而是由這些原則推導出的「穩定工作節奏模型」。 二、標準週工作課表範例 星期 主軸 內容 一 策略規劃 週目標、架構設計、優先級排序 二 深度工作 核心專案開發 / 輸出 三 深度工作 技術 / 創作 / 解決問題 四 協作日 會議、對齊、跨部門溝通 五 收斂與回顧 整理成果、復盤、下週準備 三、這種方法的三個核心優勢 降低切換成本:同類型工作集中處理 提升專注深度:減少被動打斷 讓輸出可預測:形成穩定節奏系統 四、適合誰使用? 這套方法特別適合: 工程師 / 技術職(例如 BIOS /... » read more

資深 IT 工程師如何用 AI 對話,把二十年現場經驗轉化成可傳承的方法論

知識中心 · 方法論 · 2026-05-20 · Mr. τ|風雲網通系統有限公司 起點很小很具體:只是想做一個 MTU 自動偵測工具,解決 DrayTek 搭配中華電信 PPPoE 時,LINE 電腦版卡在「正在搜尋最佳網路環境」的問題。結果這一聊,就像打開了一個開關。 對話是怎麼一層一層往上走的 和 AI 的對話沒有停在技術細節,而是像螺旋一樣,一層一層往上旋轉。 層級提升的對話過程 v0.8 腳本怎麼寫?PPPoE MTU 1492、MSS 1452、PMTUD Black Hole 成因——純工程師思維。 ↓ v1.0 這份報告要怎麼寫,才不會被客戶資安部門打回票? ↓ v1.1 這其實應該是一套結構化的現場診斷方法,而不是單一工具。 ↓ v1.2 這套方法如何變成 SI 廠商可重複交付、可培訓傳承的服務閉環? 真實案例:醫美診所的多年冤案 昨天在一家醫美診所,解決了一個讓多名工程師束手無策、拖了多年的問題。 實戰案例 · 醫美診所 症狀:網路連線極慢、換過多名工程師,問題始終沒有解決。 根因:數據機多個 LAN 埠各自建立獨立 NAT 網段,院長電腦與檔案來源主機被割裂在兩個不互通的孤島。加上檔案來源主機的無線網卡被裝潢遮蔽,訊號嚴重衰減。 解法:在三個重點位置用手機掃描 Wi-Fi 訊號,發現多個不同網段的 SSID。追出院長電腦的網路線,插回正確的... » read more

AI coding 最大成本不是 token,而是「熵」:從 Claude Code 到 Big Pickle 的地端 AI 生存工程學

PCPiLOT 部落格文章 AI coding 最大成本不是 token,而是「熵」:從 Claude Code 到 Big Pickle 的地端 AI 生存工程學 作者:Mr. τ|PCPiLOT 日期:2026-05-12 一、AI coding 的真正問題,可能不是「模型能力」 這幾天,我幾乎完整經歷了一輪 AI coding 工具鏈的「生存演化」。 從最初令人驚艷的 Claude Code,到後來不得不因額度耗盡轉往 Cursor,再到 Antigravity 的高度 autonomous coding 體驗,以及後期的大翻車,最後進入 Gemini CLI、OpenCode 與 Big Pickle 的多 Agent 協作模式。 原本我以為: AI coding 最大問題會是: 但這幾天實際與大型專案長時間協作後,我開始認為: 真正的問題,其實是「熵(Entropy)」。 不是 token。 不是 benchmark。 而是: 長時間 AI 協作後,整個工程系統逐漸失控的現象。... » read more

AI 開發體驗像坐雲霄飛車:當法力無邊的不是你,而是雲端 LLM

AI 開發體驗像坐雲霄飛車:當法力無邊的不是你,而是雲端 LLM 「我是不是突然變強了?」 最近幾週的 AI 開發體驗,真的像在坐雲霄飛車。 之前因為 Cursor 的 free tier 管控非常嚴格,只要短時間內把 tokens 用光,就會進入很長的冷卻期。長到我幾乎已經徹底棄用它,甚至快忘記自己有安裝過這套工具。 剛好這週,平常主要使用的 AI 服務付費額度也用完了。 對於目前已經習慣 AI 協助開發的人來說,這種感覺有點像: 「平常開車都開高速公路,突然被迫回去騎腳踏車。」 於是只好重新打開 Cursor,外加 Antigravity,想說至少多少補一點開發進度。 結果重新使用 Cursor 後,我其實滿驚訝的。 順暢度、理解力、執行成功率,都比我之前印象中的狀態好很多。 甚至已經開始有種: 「這東西現在真的能工作了。」 的感覺。 這其實是一件很危險,也很容易讓人產生錯覺的事情。 因為當 AI 助理開始能穩定完成工作時,人很容易進入一種: 「自己是不是法力無邊了?」 的狀態。 功能一直完成。 Bug 很快被修掉。 開發速度暴增。 原本可能要花兩三天研究的東西,現在幾小時內就能推進。 那種感覺真的很像: 一個人突然變成小型研發團隊。 但後來我慢慢發現。 真正法力無邊的,其實不是你。 而是背後那群正在燃燒 GPU 與資本支出的雲端大型語言模型。 AI 的超能力,其實是用錢燒出來的 很多人第一次大量使用 AI 開發工具時,都會被那種「超能力感」震撼到。... » read more

「當企業開始部署地端 AI,真正困難的其實不是模型」

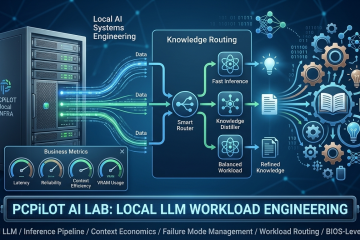
公司官網部落格版本(WordPress Gutenberg 適用) PCPiLOT 技術觀察 當地端 LLM 開始進入「工作負載工程」: 我們如何重新理解模型、Prompt 與商業效率 這不是一篇單純比較模型分數的 benchmark 報告,而是一場對「本地 AI 系統工程」的重新理解。 最近這段時間,我們在 PCPiLOT 內部進行了一輪相當完整的本地 LLM 壓力測試與工作負載分析。 測試對象包含多種模型架構、多個 Context Window、不同量化設定,以及六種企業常見知識工作場景。我們不只看模型回答「像不像」,而是開始量測: 知識密度 推理穩定性 字數控制能力 tok/s 與 wall time Context 使用效率 不同 workload 下的商業效益 而真正有趣的地方,是測試結果開始顛覆許多人對 LLM 的直覺。 一、大模型,不一定帶來更高商業價值 我們原本預期,27B 等級模型應該會明顯優於 9B 模型。但在實際測試中,結果並非如此。 某些 9B q8 模型,在多數企業知識工作場景下,輸出品質幾乎貼近 27B q4;但延遲更低、推論更快、VRAM 壓力更小。 這代表一件重要的事: 真正影響企業 AI 導入成本的,往往不是模型能力本身,而是整體推論系統效率。 在企業環境裡,真正的成本來自:... » read more

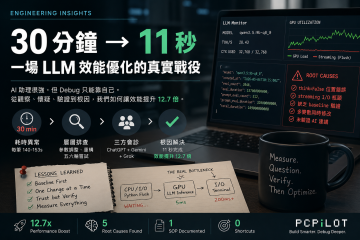
30 分鐘換來的 12 倍加速<br>本地 LLM 效能異常的根因拆解與 Debug SOP
30 分鐘換來的 12 倍加速
本地 LLM 效能異常的根因拆解與 Debug SOP

工程實戰 · Mr. τ · 2026 年 5 月 30 分鐘換來的 12 倍加速 本地 LLM 效能異常的根因拆解與 Debug SOP ▌ 這篇文章在講什麼 我花了整個上午,讓 AI 助理幫我 debug 一個本地 LLM 效能異常。六輪下來沒解決,最後靠一個三字參數位置錯誤找到根因。這是那次事件的完整記錄——以及我從中整理出來的 Debug SOP。 現象:200 字的文件,為什麼要跑 30 分鐘? 測試場景很單純:6 筆文件,每筆約 200–300 字,交給本地模型做結構化評分。正常情況下,這種規模的任務應該在幾分鐘內完成。 實際結果是:每筆 140–150 秒,6 筆合計接近 30 分鐘。 硬體監控數字正常,GPU 在線,模型已載入顯存。從表面看,系統沒有任何問題。 六輪 Debug,每輪都沒打到點 我請 AI 助理協助排查。接下來發生了一段很典型的「AI 時代 Debug 迴圈」: 1 加入串流顯示... » read more

企業數位心臟的延壽與汰換:中小企業 IT 設備管理與「避坑」全指南

IT 系統整合顧問 · Steven Lai · 2026 年 4 月 企業數位心臟的延壽與汰換 中小企業 IT 設備管理與「避坑」全指南 ▌ 前言 在多數中小企業中,IT 設備長期被視為「能用就好」的工具。電腦可以開機、網路可以上、印表機可以印,表面上一切正常。但身為技術顧問,我必須直言:這種「看似正常」,往往是風險正在高度累積的過程。 當電腦開始變慢、檔案開啟延遲、網路偶爾斷線,那不只是單點故障,而是整體系統失控的訊號。 真正的風險不在設備「壞掉」,而在於——你不知道它什麼時候會徹底崩潰。 第一章:性價比的陷阱——你買的是設備,還是風險? 1.1 家用設備「誤入」商用環境的代價 很多企業採購時只看一個指標:價格。於是家用電腦、便宜無線分享器、無網管交換器被直接搬進辦公室。 這不是品牌差異,而是設計哲學的不同: 家用設備 設計給「每天 4–8 小時」使用,著重外觀與初期購入成本。 商用設備 為了「24/7 穩定運作」而生,著重散熱設計、電容耐用度與資料安全性。 💡 顧問提醒 用家用機跑企業 ERP 與高負載工作,本質就是「過勞使用」,其電容乾涸與電源不穩的速度是商用機的數倍。 1.2 真正的成本:總持有成本(TCO)對比 項目 路徑 A 家用/低階 路徑 B 商用/專業 購入價格 $20,000 $30,000 保固期限 1 年(送修制) 5 年(到府服務) 維修成本(3... » read more

深夜收到「陌生 IP 登入警報」,<br>你知道該怎麼處理嗎?
深夜收到「陌生 IP 登入警報」,
你知道該怎麼處理嗎?

資安實務 | NAS 維運筆記 | 2026 深夜收到「陌生 IP 登入警報」,你知道該怎麼處理嗎? 從一封 NAS 警告信,學會判讀、鑑別、封鎖的完整 SOP 某天下班後,手機收到一封主旨為「嚴重|來自陌生 IP 的登入嘗試」的警報信。來源地:東歐某國家。登入帳號:公司管理員信箱。——你的第一反應是什麼? 一、這封警報信在說什麼? Synology Active Insight 會在偵測到非常規地理位置登入時自動發信通知。信中包含三個關鍵資訊: ✔ 哪個帳號被嘗試登入 ✔ 連線類型(HTTP/HTTPS) ✔ 來源所在位置(國家/地區) 收到這封信不代表帳號已被入侵,但也不能置之不理。關鍵在於:你是否能識別這次登入是否為授權行為。 二、先做鑑別診斷:正常還是攻擊? 在採取任何行動前,先冷靜確認以下三個問題: 1 這段時間有人出差或出國使用 VPN 連回公司設備嗎? 2 有委外廠商或協作夥伴被授權遠端存取嗎? 3 登入是否成功?(失敗嘗試 vs. 實際進入是完全不同的嚴重程度) 若三個問題都答「否」,就需要啟動應急處置流程。 三、哪些國家是高風險來源? 根據實際日誌分析,以下地區出現高頻率的自動化掃描與暴力破解嘗試: 風險等級 國家代碼 常見攻擊手法 高風險 CN、RU、UZ、KZ 自動化腳本掃描、帳號暴力破解 中風險 DE、NL、UA、PL 租用 VPS 作為跳板進行中繼攻擊 中風險... » read more

《Stacked Harness Engineering:從提示詞操作到多模型意圖調度系統》

📘 方法論白皮書 《Stacked Harness Engineering:從提示詞操作到多模型意圖調度系統》 🧭 0. 核心問題定義 傳統 Prompt Engineering 的隱含假設是: 使用者知道自己要什麼,並且能精確描述 但現實是: 因此問題轉換為: ❌ 如何寫出正確 prompt✅ 如何設計「讓 AI 自動收斂意圖的系統」 🧩 1. 兩個核心概念 1.1 套疊與修正(Stacking & Refinement) 不是一次生成,而是: 多層輸出 → 比對 → 修正 → 再生成 可以抽象成: 📌 重點不是「生成一次」,而是: 讓錯誤在系統內被逐層消化 1.2 Harness Engineering(調度工程) Prompt Engineering 在做的是: 「寫輸入」 Harness Engineering 在做的是: 「設計 AI 行為路徑」 包含四個層次: (1)... » read more

看不見的衝擊: 電力突波 與 電壓不穩
看不見的衝擊: 電力突波 與 電壓不穩

案例分享 · NAS實戰日誌 年久月深的暗內傷 ⚡ NAS 壞掉,很多時候不是 NAS 的問題 上一篇我們談到 Gateway 被換掉導致 VPN 備份通道消失。但那個案子還有另一條線,同樣重要,卻更容易被忽略。 分站的 NAS 一直不穩定。現場需要反覆到機房手動重開,時好時壞,沒有規律。客戶的直覺反應是:設備壞了。但二十年的現場經驗告訴我,這種「飄忽不定」的症狀,電力出問題的比例,遠比設備本身故障來得高。 ⚠️ 電力不穩,你不一定感覺得到 這是這類問題最麻煩的地方。 電力不穩定不會每次都讓設備直接掛掉。它是一種慢性傷害。突波來的時候,硬碟可能剛好在寫入資料,這一筆就壞了。電壓短暫壓降的時候,系統可能剛好在做備份,這一次就中斷了。日積月累,系統事件紀錄裡開始出現一堆你看不懂的錯誤代碼,設備越來越不穩定,最後你以為是設備老化,送去檢測卻找不到明確原因。 這種狀況在台灣的中小型廠區很常見。廠房裡的電力品質本來就比辦公室複雜,機具啟動時的瞬間電流、老舊配電盤的電壓波動,都會影響到同一迴路上的所有設備。 💰 一個很現實的對比 很多老闆願意幫廠區內的生產設備配穩壓器,卻讓存著所有客戶資料、訂單記錄、財務文件的 NAS,直接插在牆上的普通插座。 這個選擇背後的邏輯我能理解:生產設備壞掉,產線馬上停;NAS 壞掉,感覺還能撐一下。問題在於,設備壞掉,保固換新台;資料壞掉,沒有人能保證幫你還原。 這台 NAS 還在保固期內。但保固保的是硬體,不是裡面的資料,也不是你因為系統中斷而損失的工作時間和業務機會。 🛡️ UPS 不是選配,是基本配備 很多人對 UPS 的認知只有一個:停電的時候讓電腦多撐幾分鐘。這個理解只對了一半。 UPS 真正重要的功能是兩件事:防突波,以及穩壓。 功能 保護你的方式 防突波 瞬間高壓出現時擋在設備前面,避免元件壽命被每次衝擊慢慢耗損 穩壓 供電電壓不穩時持續輸出穩定電壓,讓設備不用承受忽高忽低的電力品質 一台適合 NAS 使用的 UPS,價格從幾千元到一萬多元都有。對應的,是你存在 NAS 裡面的資料價值,以及萬一出事之後的救援成本與業務損失。這個對比,大多數老闆算一下就清楚了。 🔍 這個案子的額外發現 這次排查過程中,我們順手把整個內網的設備清單重新盤點了一次。 一個健康的內網,應該要能清楚回答幾個問題:現在線上有哪些設備?每台設備的角色是什麼?哪些設備是關鍵節點,一旦出問題會影響整體運作?... » read more

【案例分享】誰動了你的 Gateway?

三十六計 之 第二十五計:偷梁換柱 一間公司的網路壞掉,通常不是壞,是「被改了」。 這次的案子從一通求助電話開始。客戶反映 NAS 狀態不穩定,異地備份任務也持續出現錯誤。遠端連進去診斷,我就知道這不只是設備問題。 ━━━━━━━━━━━━━━ 📡 異常一:設備看得到,但抓不到 第一個奇怪的地方出現了。 用原廠提供的管理工具,可以正常找到 NAS 的詳細資訊。但換成一般的網路掃描工具,或者直接查 ARP 表,卻完全看不到這台設備的 IP 存在。 這種「廠商工具看得到,標準協定看不到」的狀況,通常意味著網路層出了問題,而不是設備本身故障。這是第一個線索。 ━━━━━━━━━━━━━━ 🔀 異常二:Gateway 被換掉了 接著進行更詳細的網路掃描,發現一件讓我高度警覺的事。 這個客戶原本的網路架構設計是這樣的:主站與分站各自部署一台企業級 VPN 路由器,兩台設備透過 Internet 建立加密通道,讓分站的 NAS 可以定時將資料備份到主站的 NAS。這是一個相對標準、可靠的異地備份架構。 但掃描結果顯示,分站那一端的企業級 VPN 路由器,已經被換成了一台消費級 Wi-Fi 路由器。 現場詢問了相關人員,才得知是分站同仁自行找當地店家協助處理網路問題,店家在不清楚原有架構的情況下,直接把路由器換掉了。新的設備沒有 VPN 功能,也沒有留下任何管理帳號與密碼。 結果很直接:兩個站點之間的 VPN 通道完全消失,分站 NAS 的所有備份任務全數失敗。但內部的日常檔案存取,還勉強維持正常運作——這也正是最危險的地方。沒有人知道備份已經中斷多久了。 ━━━━━━━━━━━━━━ ⚡ 異常三:分站 NAS 還有另一個獨立問題 排查過程中發現,分站的 NAS 本身也有狀況。 設備會不定時從網路上消失,需要現場人員到機房手動重開才能恢復。這種「時好時壞」的症狀,加上現場環境沒有配置 UPS,研判與電力品質不穩有直接關係。突波與電壓不穩定,不會每次都讓設備壞掉,但會讓系統累積異常、縮短硬碟壽命,並在你最不注意的時候讓備份中途中斷。... » read more