從氣冷極限到後 3M 時代:解密 AI 伺服器散熱的物理限制與商業博弈

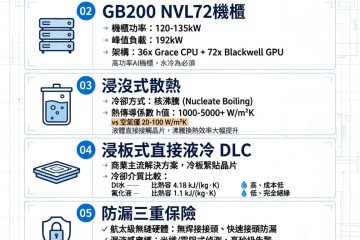
工程師思路系列・事出必有因 從氣冷極限到後 3M 時代:解密 AI 伺服器散熱的物理限制與商業博弈 作者:Mr. τ / 風雲網通系統 隨著生成式 AI 與大型語言模型的爆發,AI 晶片的功耗正以恐怖的速度飆升。當單顆 GPU 的功耗跨越 1000W 大關、單一機櫃發熱量衝破 120kW 時,散熱技術已經不再是硬體的「附屬品」,而是決定 AI 算力能否完整釋放的核心關鍵。 💡 本文要回答的問題 許多科技影片都說「氟化液浸沒式散熱比傳統氣冷強 10 倍」。這在物理上是如何辦到的?既然如此強大,為何當前的 AI 機房依然以局部水冷(冷板式)為絕對主流?本文從物理特性、成本效益、應用場景與風險控制,全面拆解這場散熱革命。 一、氣冷(風冷)的「物理天花板」 傳統資料中心依賴風扇帶動空氣流動,配合機房冷氣進行解熱。然而,風冷系統存在著無法跨越的物理極限: ✔ 單櫃解熱上限:工程實務上,傳統氣冷機櫃的散熱極限普遍落在 15 ~ 25 kW。即便透過極致的氣流優化與後門熱交換器(RDHx),頂多也只能勉強推至 30 ~ 40 kW。超過這個範圍,熱點(Hot Spot)累積與風扇自身的功耗將會急劇上升。 ✔ 物理性質的孱弱:空氣的熱傳導與帶熱能力天生弱勢。常溫下的比熱容僅約 1.0 kJ/kg·K,且體積熱容極低,這意味著要帶走相同的熱量,需要極為龐大的風量。 ✔ 能源與噪音代價:為壓制高功耗晶片,風扇必須拉高至上萬轉。這不僅帶來如同飛機場般的機械振動與噪音,更使資料中心的 PUE(電力使用效率)高達 1.3 ~ 1.8,大量電力被白白浪費在「吹風扇」與空調上。 當前主流的 AI 伺服器機櫃(如... » read more
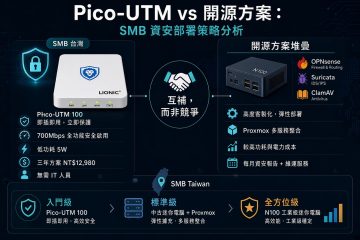
從硬體架構、DPI 引擎原理到 SMB 商業模式——為什麼這兩種方案根本不在同一個維度競爭?

資安工程 UTM 評估 開源方案 工程師思路系列 從硬體架構、DPI 引擎原理到 SMB 商業模式——為什麼這兩種方案根本不在同一個維度競爭? 問題起點:能否用開源方案取代 Pico-UTM? Pico-UTM 100 的市場定價約 NT$12,980(三年特徵碼/韌體更新含主機,市場參考價,依通路與時間而異)。從 IPQ4018 此類 SoC 的量產規模推估,售價結構應包含硬體與多年授權費兩個部分,授權費佔比不低。問題是:能用開源方案組合出 70~80% 的同等功能嗎? ▌ 結論先說 偵測能力可以做到 75~85%,但「難拚」的點不在功能,在工程取捨與商業模式。開源方案和 Pico-UTM 根本是不同維度的產品。 難拚的根本原因有三個層次:引擎技術(Lionic 自有 DPI 演算法)、硬體成本(ARM SoC 大量製造壓低成本)、責任歸屬(盒子本身就是一份保固承諾)。 Pico-UTM 100 硬體規格解析 規格項目 數值 說明 CPU Qualcomm IPQ4018 4 核 ARMv7 Cortex-A7;官方 spec 600MHz,板廠超頻至 700~716MHz 是常態,日本代理商標示 710MHz RAM 256MB 串流式掃描設計,不需將整個檔案暫存 Flash... » read more

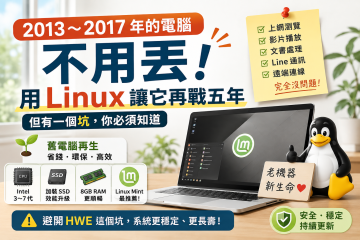
用 Linux 讓它再戰五年——但有一個坑,你必須知道 (長篇)

工程師思路系列・事出必有因 2013~2017 年的電腦不用丟 用 Linux 讓它再戰五年——但有一個坑,你必須知道 Intel 3~7 代 CPU 的電腦,因為上不了 Windows 11 被大量拋棄。 但這些機器的硬體沒問題。選對 Linux、配對軟體、避開 HWE 這個坑——它還能跑五年。 #Linux #舊電腦再生 #SMB #HWE警告 #Linux Mint 一、那些「沒壞」卻被拋棄的電腦 Windows 10 已在 2025 年 10 月停止支援。官方下一步是 Windows 11——但 Microsoft 要求 CPU 至少是 Intel 第 8 代(Coffee Lake),還得有 TPM 2.0 晶片。 結果是:大量 2013~2017 年間的電腦,配置的是 Intel 第 3 代(Ivy Bridge)到第 7... » read more

24GB 顯示記憶體,為什麼跑不動 16GB 的本地 AI 模型?

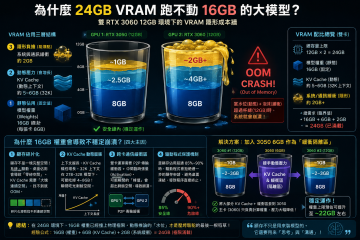
技術觀察 · AI Infrastructure 24GB 顯存,為什麼跑不動 16GB 的本地 AI 模型? Mr. τ/風雲網通系統 · 本地 LLM 部署實測觀察 很多玩家的第一反應:「我有兩張 3060,加起來 24GB,跑個 16GB 的模型理論上完全沒問題啊?」 實測結果卻是:載入沒事,一開始對話就隨機崩潰。這不是顯卡壞了。是 VRAM 的本質被誤解了。 💡 核心觀念:VRAM 是預算,不是倉庫 很多人把 VRAM 想成靜態的硬碟空間。但跑 LLM 推論時,它更像是一個「會呼吸的緩衝區」。16GB 的模型進了顯存之後,只是第一筆支出,後面還有更多看不見的隱形成本持續消耗。 一個更直觀的比喻:VRAM 是電梯的「額定載重」,而 16GB 的模型只是乘客的體重。電梯運行時的機械摩擦、剎車瞬間的衝擊力(推論峰值)——這些才是讓系統超載的真正原因。 📦 消失的顯存去哪了?三層隱形成本 1 靜態模型權重(固定 16GB) 這是你看得見的部分——模型進了 VRAM 就不動了。誤區正是從這裡開始,很多人以為「剩下 8GB 就是安全空間」,但實際上那 8GB 要承擔後面所有的動態壓力。 2 KV Cache 的「呼吸效應」(4~8GB,且隨時間膨脹) 這是最關鍵的時間變數。LLM 是有記憶的,每一輪對話都要把前面的內容儲存進... » read more

24GB VRAM 的生存法則:為什麼 26B 模型會讓你的地端 AI 體驗撞牆?

前言:效能與品質的拔河 在追求地端大型語言模型(LLM)的過程中,許多企業主與開發者常面臨一個抉擇:在現有的硬體資源(如單片 24GB 顯存環境)下,究竟該追求模型參數的大小,還是追求輸出的穩定性? 最近我在實際操作 PCPiLOT 的核心邏輯時,對 26B / 27B 等級模型進行了深度測試,發現了一個極為現實的技術瓶頸。這篇文章將解析為什麼「模型塞得進去」不代表「真的好用」。 一、 模型變大,不代表生產力提升 以 26B / 27B 等級的模型(如 Qwen 或 Gemma 系列)來說,輸出的邏輯與表達確實非常出色,甚至接近商用等級。 但問題在於:在 24GB VRAM 的環境下,這類模型幾乎把資源吃到極限。這就像一台超載的貨車,雖然還能上路,但已經沒有任何避震空間與加速餘裕。 二、 隱形的效能殺手:KV Cache 與上下文長度 許多人評估硬體時,只看「模型權重大小」,卻忽略了推論過程中的動態變數: 當 VRAM 被模型權重與 KV Cache 噴滿後,系統會被迫將資料外溢到電腦記憶體(RAM)。此時,推論速度會出現「斷崖式下降」,從流暢的每秒十幾字,變成讓人難以忍受的一秒一字。 三、 實戰取捨:為何我目前改採 9B 模型? 為了確保 PCPiLOT 知識中心的運作效率,我目前的工程策略是改用 Qwen 3.5 9B 先撐住。這並非退步,而是基於「可用性」的權衡: 這是一個典型的工程觀念:不追求極致的靜態品質,而是追求「可用性 + 穩定性」的綜合表現。 四、 給地端部署者的三條建議 五、 結語:專業顧問的價值... » read more

老電腦的加速強化劑 — SSD (固態硬碟)

連續幾天, 協助老客戶安裝公司內好幾台老電腦的固態硬碟. [現場情況] 大約是 2011~2015 年份左右的電腦, 使用的傳統 3.5″ 硬碟, 不敵歲月摧殘, 大多有讀取緩慢或者困難的狀況. 配置的 CPU PassMark 分數落在 2300~3200 分(都是四核心), 以現代電腦來看, 勉強算是文書/查詢資料所堪用的電腦. 至於記憶體, 該加的就加上去, 至少拱到 4+8=12GB 或者 8+8=16GB. 原本出廠配置的老硬碟, 確實已經出現疲老情況, 各類的壞磁區或者無法修復的狀況, 造成作業系統複製程序時間拉長, 要移轉到 SSD 所需的複製系統的時間, 因為磁碟讀取困難問題, 變成原本正常硬碟複製時間的 n 倍 (5<n<10) 所幸最後還是都複製完成, 順利讓老電腦有了 固態硬碟開機/存取的效能, 使用者收到改裝固態硬碟的電腦後, 都非常驚豔於電腦反應速度之快. [改造成果] 其實, 只是脫離老邁硬碟的讀寫速率, 回到較為近乎 CPU 處理的效能, 不再被傳統硬碟低 I/O 以及 低傳輸速率所拖累. 成熟的固態硬碟零組件, 真的可以讓老舊電腦使用者, 很有感於工作效率的提升.... » read more