一台印表機故障,如何長出一套診斷工具
一台印表機故障,如何長出一套診斷工具

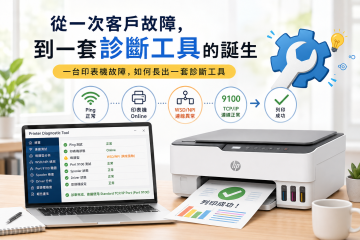
從一次客戶故障,到一套診斷工具的誕生 工程師思路系列:好心辦壞事 —— 一台印表機故障,如何長出一套診斷工具 有些問題,看起來像設備故障。 有些問題,看起來像驅動程式損壞。 但真正深入追查後才發現, 問題其實來自一個原本出於善意的設計。 這次的個案,就是如此。 問題出現 家中有一台 HP Smart Tank 510 無線印表機。 多台 Windows 11 電腦長期正常使用。 但其中一台電腦,某天開始突然無法列印。 更奇怪的是: 測試頁正常 印表機狀態頁正常 Ping 正常 印表機顯示 Online 唯獨 PDF 與 Word 文件送出後, 印表機只動一下就停住。 彷彿設備正常, 卻又無法真正工作。 第一輪排查 遇到這種問題時,最重要的不是急著修復, 而是先排除錯誤假設。 於是開始逐項驗證: 重新安裝 HP 官方完整驅動 確認 Wi-Fi 連線正常 確認其他電腦可正常列印 確認印表機韌體正常 確認網路可正常 Ping 通 結果全部通過。 問題依然存在。 此時可以確定: 印表機本身並沒有壞。... » read more

三個不同案例,相同的處理態度與思路
三個不同案例,相同的處理態度與思路

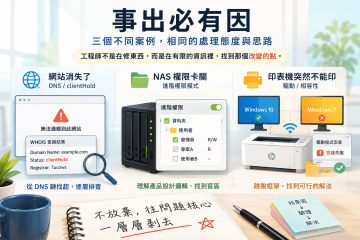
三個不同案例,相同的處理態度與思路 —— 事出必有因系列:不放棄,往問題核心一層層剝去 今天處理了三個 SMB 客戶的現場案件。 網站與信箱突然全部中斷、NAS 權限設定怎麼改都沒用、診所印表機突然不能列印。 三件事看起來毫無關聯,但處理完之後,我發現它們其實在說同一件事: 每一個「突然壞掉」,都只是入口。真正的工作,是從入口走進去,一層一層,直到找到那個改變的點。 案例一|公司網站與信箱同時消失 客戶早上傳訊息過來:「官網打不開,寄出去的信全部退回。」 第一反應不是叫他去問主機商。 因為網站無法存取,不一定是主機壞了。第一順位的懷疑,是 DNS。 查了 WHOIS,果然——域名出現了 clientHold 狀態。 這個狀態代表:域名在註冊商端被暫時凍結,整個 DNS 解析鏈中斷,網站、信箱、所有對外服務,全部同時消失。 問題是,這個案件牽涉四個環節: 環節 負責方 域名註冊 國外供應商 Tucows,台灣由遠振代理 網站架設 另一家廠商維護 郵件服務 Google 代管 現場 IT 客戶自行處理 四個環節,沒有一個有完整的第一手資訊。能做的,是透過即時聊天持續與客戶確認現象,同時用 DNS 查詢工具監測狀態,逐層排查。 大約三、四個小時後,clientHold 自動解除,服務恢復正常。 原因?到現在還沒有明確答案。 這就是某些案件的現實——你找到了問題在哪裡,但「為什麼發生」這個問題,有時候沒辦法有完美的結論。 📌 企業主應該知道的事 域名是你公司數位資產的地基。地基出問題,上面所有東西同時消失——網站、信箱、一切對外的數位服務。 它不在你的主機上,不在你的 IT 人員手裡,它在域名註冊商那裡。 幾個值得確認的問題:你的域名在哪家註冊商?續費通知寄到哪個信箱?負責人離職後,這些資訊還在公司手裡嗎? 案例二|NAS 權限設定怎麼改都不生效 建築師事務所,Synology NAS。 管理員反映說有兩個資料夾的存取權限怎麼設都沒用——帳號正常,操作步驟也對,就是不生效。... » read more

收斂的委員會:Decision Convergence Engineering 的一次實踐

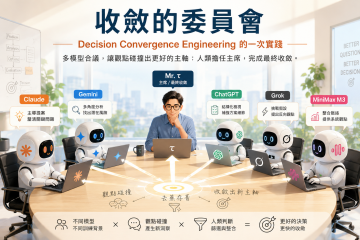
個案經驗分享 · AI 應用實戰 · 決策工程 收斂的委員會 Decision Convergence Engineering 的一次實踐 人越多,越難收斂——這是多數人對開會的印象。但我的經驗剛好相反:當與會者全是 AI,收斂速度反而比任何真人委員會都快。 Mr. τ / 風雲網通系統 · 2026 🤔 一個違反直覺的觀察 很多人對開會的直覺是:人越多,立場越多,越難有結論。 這個直覺在真人世界裡完全正確。但當與會成員換成 AI 助理,這個規律就失效了。 我長期使用多模型合議來輔助重大決策,觀察到一件事:AI 委員會的發散速度很快,收斂速度也很快。 而且幾乎不需要主席強行裁決——觀點的碰撞本身就會自然篩選出值得保留的東西。 ⚖️ 真人委員會 vs AI 委員會 真人委員會難以收斂,不是因為人不夠聰明,而是因為人帶著太多與問題本身無關的東西進入討論: 真人委員會的阻力 AI 委員會的特性 權力鬥爭與派系利益 ✔ 無組織政治 面子問題、不願認錯 ✔ 無自我防衛 情緒反應與歷史包袱 ✔ 每次對話都是新的起點 部門本位、各守地盤 ✔ 只針對問題本身給出立場 開會時間有限、精力有限 ✔ 幾分鐘內給出有結構的完整立場 AI 之間觀點不同,但沒有任何一個模型有「贏過其他模型」的動機。它們只是在回應問題本身。這讓討論的訊噪比大幅提高。 🧭 實際流程是這樣跑的 我的主導... » read more

AI 時代工作法企業 AI 治理知識工程

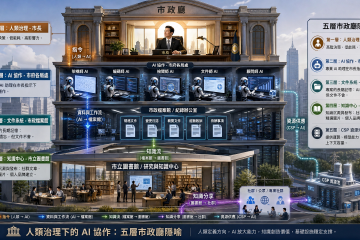
AI 時代工作法 企業 AI 治理 知識工程 你不需要懂 AI, 但你需要當市長 從三個真實事故,長出來的企業 AI 治理架構 Mr. τ/風雲網通系統有限公司  ·  2026 有一次,我交代一個任務給 AI 助理。 它沒有問我任何問題,直接開始工作。 三十分鐘後,它回報完成了。 但它做的,不是我要的那件事。 它自己判斷了工作範圍,自己決定了方向,然後非常認真地,走錯了路。成本,照單全收。 這不是特例。這件事在不同形式下,我遇到了很多次。 每次我都在想同一個問題: 如果 AI 不知道邊界在哪裡,它會自己畫一條。 而那條線,不一定是你要的那條。 這個問題,帶過人的主管都遇過。新進員工摸不清楚狀況,做了一堆不在範圍內的事;外包廠商沒有接到明確指令,就按照自己的習慣走。AI 也是一樣——只是它做事的速度快很多,所以走錯的代價也大很多。 後來我把這些事故整理了一遍,發現它們都指向同一個根本原因: 不是 AI 不夠聰明。而是沒有人在治理它。 這也是我後來畫出這張圖的原因。 [ 五層市政廳架構圖 ] 人類治理 → AI 協作 → 文件系統 → 知識中心 → CSP 基礎設施 這張圖把企業 AI 協作拆成五層。每一層,我都曾經在真實事故裡感受過「缺了它會怎樣」。 以下,我用三個事故來解釋這張圖。 事故一:它很認真,但沒有人告訴它邊界在哪裡... » read more

AI 沒有猜錯,但我還是不知道自己在看哪一張 RTX 3060

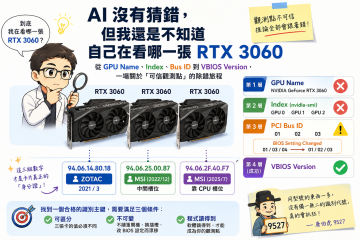
AI 沒有猜錯,但我還是不知道自己在看哪一張 RTX 3060 從 GPU Name、Index、Bus ID 到 VBIOS Version,一場關於「可信觀測點」的除錯旅程 最近在研究 Ollama 與 llama.cpp 的 GPU 排程行為。一開始只是想搞清楚幾個小問題:為什麼 Windows 工作管理員看到的數字,跟 nvidia-smi 看到的不太一樣?為什麼有些模型看起來應該跑在某張卡上,行為卻又不像? 查著查著,我突然發現一個更根本的問題: 我根本不知道自己正在看哪一張 RTX 3060。 我的機殼裡插著三張長得一模一樣的 RTX 3060:同晶片、同 12GB 容量、外觀幾乎沒有差別。當兵時學過「四清、兩點、五查、三找」,裝備識別一個都不能少。沒想到二十年後在自己家裡,我被三張顯示卡逼著把這套紀律重新拿出來用——而且用得比當兵時還狼狽。 GPU 識別其實不是問題本身。它是為了驗證推論系統行為,不得不先解決的前置問題。觀測點如果不可信,後面所有的推論都會跟著錯。以下是這趟除錯的完整過程,包含 AI 助理陪我一起猜錯的每一層。 四層誤判 1第一層誤判:GPU Name 三張卡通通顯示 NVIDIA GeForce RTX 3060。完全沒用,毫無區別。 2第二層誤判:nvidia-smi 的 Index(GPU 0 / 1 / 2) 很多人第一反應是看 Index。但這台機器一路從 GTX 750... » read more

36GB VRAM 的幻覺:我讓三家 AI 預測 RTX 3060 ×3 的推論效能,結果全部輸給實測數據

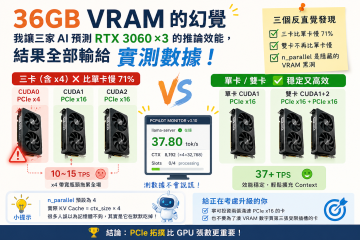
36GB VRAM 的幻覺:我讓三家 AI 預測 RTX 3060 ×3 的推論效能,結果全部被數據打臉 Mr. τ/風雲網通系統 · 2026-06-10 · 地端 AI 基礎設施 一、心動的開始 前幾天,社群裡流傳一篇文章。 有人用 RTX 5090 在本地跑 Gemma 4 12B,透過一個參數調整,TPS 從 27 直接飆到 103。將近四倍。 看完之後,我盯著螢幕想了很久。 「我手上有三張 RTX 3060 12GB,加起來 36GB VRAM。應該也能跑得很猛吧?」 其實買第三張卡的初衷很務實。不是為了炫耀規格,而是有實際需求: 兩張卡跑大一點的模型,偶爾會 OOM(顯存不足),動不動就崩 想測試 26B、27B 等級的模型,需要更寬裕的 VRAM 緩衝 不希望因為顯存限制,就把好不容易找到的優質模型放棄 帶著這個期待,我做了一件很多人都會做的事:先去問 AI。 💡 小科普:什麼是 TPS? TPS = Tokens Per... » read more

看懂 Qwen3-30B-A3B-QAT-Instruct-Q4_K_M-MTP-NSFW:2026 地端 AI 模型命名學完全指南

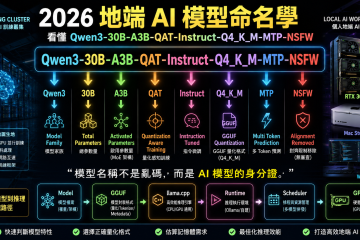
看懂 Qwen3-30B-A3B-QAT-Instruct-Q4_K_M-MTP-NSFW:2026 地端 AI 模型命名學完全指南 從模型名稱看懂參數規模、MoE 架構、量化格式與推理優化 當你開始接觸地端 AI(Local AI)之後,很快就會發現一件事: 最大的障礙不一定是顯示卡,也不一定是 Linux。 而是模型名稱。 第一次看到: Qwen3-30B-A3B-QAT-Instruct-Q4_K_M-MTP-NSFW 很多人的反應通常都是: 「這到底是模型名稱,還是 Wi-Fi 密碼?」 事實上,這串名稱並不是亂命名。 它其實是在用最短的字數,描述模型的架構、規模、量化方式、推理特性與用途。 如果能看懂這些縮寫,你幾乎可以在下載前就判斷: 需要多少記憶體? 跑起來快不快? 適合聊天還是寫程式? 是否支援特殊優化? 是否有安全限制? 一、30B 是什麼? 30B 指的是: 30 Billion Parameters 也就是 300 億參數。 參數可以理解成模型在訓練過程中學到的知識權重。 模型規模 常見用途 3B 輕量聊天助手 7B 個人 AI 助理 14B 進階推理 30B 高品質通用模型 70B+ 接近大型商業模型能力 通常參數越大,能力越強,但所需記憶體也越高。 二、A3B 是什麼?... » read more

工作管理員說 llama-server 吃了 17GB RAM 我把整個過程錄下來了

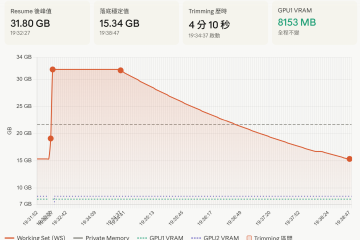
本地 AI 推論 · 記憶體診斷 工程筆記 · 實測紀錄 Mr. τ/風雲網通系統  ·  2026-06-09 我有一台 64GB RAM 的地端 AI 主機,平常系統總用量很少超過 16GB。那天睡眠喚醒後,瞄到用量靠近 32GB,直覺就覺得不對。打開工作管理員,最顯眼的那行是 llama-server.exe,排在所有程式最上面,佔了 17GB。 第一個念頭:GPU offload 掛了,Qwen3.6 27B 整個跑回 CPU 了? 但 nvidia-smi 一查,GPU1 8153MB、GPU2 8701MB,紋絲不動。推論速度 18.6 tok/s,也沒事。 GPU 好好的,模型在跑,但 RAM 突然多了將近一倍的用量。 那個 17GB 到底是什麼? 我沒有重開機。我寫了一個監控程式,把整個過程錄下來。 實測數據:163 筆,每 2 秒一筆 程式從喚醒前就跑著,Sleep/Resume 全程自動記錄。以下是這次事件的完整時間軸。 19:31:52 ── 基準線 llama-server Working... » read more

原來整理 GPU,也是在做裝箱演算
原來整理 GPU,也是在做裝箱演算

原來整理 GPU,也是在做裝箱演算法 最近在研究本地 AI 推理環境時,遇到一個非常有趣的問題。 我的測試主機配置了三張 RTX 3060 12GB 顯示卡。其中兩張透過 PCIe x16 運作,另一張則作為亮機卡使用,只連接 PCIe x4。 乍看之下,總共有 36GB VRAM 可供運用。然而在實際部署大型語言模型時,事情遠比想像中複雜。 有些模型可以獨立運行於單張 GPU;有些模型則需要跨兩張 GPU 分攤權重;還有些模型雖然容量不大,卻需要與其他服務共同分享有限的記憶體空間。 這讓我開始思考一個問題: 如何讓有限的 GPU 資源,發揮最大的模型部署效益? Bin Packing:經典的裝箱問題 深入研究之後,我發現自己面對的其實是一個經典的電腦科學問題:Bin Packing(裝箱問題)。 所謂裝箱問題,可以用生活中的行李打包來理解。 每張 GPU 就像一個行李箱。 每個 AI 模型就是一件行李。 GPU VRAM 就是行李箱容量。 模型大小則是行李體積。 目標是在不超過容量限制的前提下,把所有行李放進有限的箱子裡,並盡可能提高空間利用率。 這看似簡單,實際上卻是著名的 NP-Hard 問題之一。 真實世界比數學題更複雜 如果只是比較模型大小與 VRAM 容量,問題其實不難。 然而在實際部署環境中,還會出現許多額外限制: 某些模型禁止部署於亮機卡。 某些模型必須跨兩張 GPU 運行。... » read more

AI 時代最容易被遺忘的能力:保留替代路徑

AI 時代最容易被遺忘的能力:保留替代路徑|PCPiLOT PCPiLOT 技術觀點 AI 時代最容易被遺忘的能力:保留替代路徑 Mr. τ/風雲網通系統 · 2026 昨天找鍵盤滑鼠的 USB 接收器,找了半天,沒找到。工作用電腦沒有輸入裝置可操作,第一個反應很直接:上網下單。火箭速配,Logitech MK275 一組,昨夜按下去,今天到貨。這大概也是現代人最自然的解法——缺什麼,就買什麼。 等貨的空檔,腦子突然轉了一圈。 我家地下室不是有一堆有線鍵盤滑鼠嗎? 於是下樓翻找。一落整理好的 PS/2 鍵盤,挑了一把看得順眼的;牆上掛鉤還有幾支 USB 有線滑鼠,拿下一支,插上去,電腦重新上線。MK275 還在物流車上,問題已經解決了。 看起來只是件小事。但事後回頭想,真正有意思的地方不在於我找到了鍵盤,而是:我第一時間想到的是購買,而不是盤點現有資源。效率,正在悄悄改變我們解決問題的方式。 公理號的隱喻 《瓦力》(WALL-E)中的公理號(Axiom)是個有趣的隱喻。船上一切都被最佳化了:移動由懸浮椅代勞,資訊由螢幕主動推送,生活由自動化系統全面照顧。人類不需要規劃,不需要修理,不需要尋找替代方案,更不需要處理意外狀況。 這艘船最可怕的地方,其實不是機器人管理人類,而是整個系統已經把「解決問題的能力」從人類身上逐漸抽離。當一切正常運作時,這種設計看起來非常成功。但當系統失效時,人類已經失去了接手的能力。 皮克斯在 2008 年就把這個場景拍出來了。不是預言,是觀察。 企業現場也在發生同樣的事 這讓我想到許多企業資訊系統的現況: 交換器故障了 買新的 NAS 空間不足了 買新的 伺服器效能不夠了 升級硬體 AI 額度不夠了 升級方案 這些決策未必錯誤。但很多時候,問題並非資源不足,而是對既有資源缺乏理解。 許多企業追求極致效率時,最先被犧牲的往往就是那些看似多餘的東西:備品庫存、備援設備、技術文件、知識庫、交接紀錄、替代流程。它們平常不產生營收,看起來佔空間,甚至讓人覺得浪費成本。於是被逐步裁撤。直到某位資深員工離職、某台核心設備故障、某個雲端服務中斷,大家才發現,系統其實沒有第二條路。 那落 PS/2 鍵盤的系統工程意義 回到那批 PS/2 鍵盤。它們平常幾乎沒有存在感,甚至十年都未必會被拿出來一次。但昨天,它們扮演了重要角色。 從系統工程的角度來看,它們其實就是一種 Cold Standby——平時閒置,必要時接手。 關鍵前提 我能翻出那落 PS/2 鍵盤,有一個前提——我當初沒有丟掉它。這不是節儉,也不是囤積癖,而是一個主動的決策:對未來不確定性的預判與準備。... » read more
Prototype 能動,不代表 Product 能活

軟體工程 AI 協作 SMB 數位轉型 委外 CKO Prototype 能動,不代表 Product 能活 AI 時代的「原型膨脹幻覺」與複雜度治理,一篇給想動手者、也給評估委外者的清醒文 這兩年,很多人第一次有了「原來我也能做軟體」的感覺。 對著大型語言模型(LLM)下幾段精準的指令,網頁登入畫面會自己長出來,資料庫結構會自己建,API 串接、Docker 容器化、前後端框架——AI 助理都能在幾分鐘內幫你完成初稿。這是一個非常真實的突破。過去阻擋許多企業與領域專家的,是程式語言本身的高門檻。而現在,那道牆正在鬆動。 許多原本因為「缺人缺錢缺時間」而永遠啟動不了的專案,終於第一次有了「從 0 到 1」的可能性。這件事,我們是真心欣喜的。 但也因為進入門檻的全面民主化,市場正在出現一種全新的治理盲區——我們在現場看了二十年,必須把實情說清楚。 📌 什麼是「Prototype Inflation(原型膨脹幻覺)」? 越來越多團隊第一次成功做出了 Demo,看著畫面上會跑會動的介面,就誤以為自己已經完成了產品。網路上充滿「用 AI 10 分鐘做一個 App」的激情短影音,卻極少有人以「在 Production 生產現場活過二十年」的視角,冷靜地指出後面那個會爆炸的修羅場。 Prototype 能動,不代表 Product 能活。 這句話,是這篇文章最想傳遞的一件事。 先說給「想自己動手」的你聽 LLM 是一個真實的能力放大器。如果你在自己的領域有深厚的知識與經驗,你現在確實是最適合動手嘗試的一群人——因為你知道痛點在哪、知道答案對不對、知道什麼才算「真正能解決商業問題」。 但是,軟體工程是非常現實的事情。Demo 階段的美好,和實際營運階段的考驗,是兩個完全不同的世界。當你的系統脫離實驗室、準備承擔商業責任時,真正的複雜度治理挑戰,才正要開始。 如果試了之後發現自己或內部團隊確實不那麼擅長軟體架構與生命週期管理——請點頭承認,這也是非常正常且理性的經營判斷。交給相熟且具備實戰經驗的 IT 專家處理,是最務實的選擇,不是認輸。 ⏳ 時代的隱形風險:限制消失了,系統在理解複雜度前就已長大 在過去,軟體開發緩慢的步調,某種程度上其實是對企業的一種隱形保護。因為開發慢、成本高,團隊在初期就會被迫面對各種預算、人力與技術限制,這反而促使團隊提早去思考模組劃分、運維流程與權限資安。 但 AI 時代打破了這個保護機制。現在最大的風險,不是做不出系統,而是開發速度太快了——快到團隊還來不及建立系統防禦力,就已經利用 AI 把系統盲目堆大了。這種缺乏地基的補丁式系統,一旦進入市場,隨之而來的工程現實一個也逃不掉。... » read more

用 AI 做決策這件事,其實是火箭工程的延續

工程思維 × 知識管理 用 AI 做決策這件事,其實是火箭工程的延續 從挑戰者號到多模型投票機制——容錯從電路搬到了語言層 Mr. τ/風雲網通系統  |  PCPiLOT 知識管理實驗室 最近在收斂一個客戶專案的解決方案規格時,我刻意做了一個設計上的決定: 不再依賴單一 AI 給答案,而是同時讓 3~4 個模型互相審查、主動挑錯、填補盲點,最後才收斂成可以落地的方案。 這件事乍看像是「AI 工具的用法選擇」,但它其實更像一個老到不能再老的工程問題:如何避免關鍵系統在最後一刻因為「大家都同意」而悄悄崩潰。 1986 與 2003:不是技術失誤,是裁決機制失敗 挑戰者號(1986)與哥倫比亞號(2003)的兩場災難,事後復盤都不是單點錯誤,而是暴露出同一種結構性缺陷: ✗ 工程師的警告訊號存在,但在層層彙報中被稀釋 ✗ 邊界條件被逐步「正常化」——這次看起來跟上次一樣,應該沒事 ✗ 最終裁決壓縮成一個二元問題:Go / No-Go,沒有灰度,沒有異議空間 真正的問題不是火箭的材料或設計,而是:錯誤被系統性地放行了。決策系統說服了自己「這次應該也沒事」。 火箭工程早就給過答案:TMR 三模冗餘 阿波羅任務與土星五號時代的導航電腦,採用了一個當時極為硬派的工程解法——TMR(Triple Modular Redundancy,三模冗餘): 機制 說明 三套獨立系統 同時計算同一個問題,彼此不知道對方的答案 硬體投票裁決 少數服從多數,異常值直接被隔離 無 rollback 設計 太空中沒有重試機會,容錯必須在決策當下完成 這個設計的核心哲學不是「讓系統更聰明」,而是:假設任何單一系統都可能出錯,所以在架構上就不允許它單獨做最終裁決。 現在的 AI,重新打開了同一個問題 單一大型語言模型的問題不在於能力不足,而在於它有幾個結構性弱點: ▸ 幻覺(Hallucination)——以高度自信的語氣輸出不存在的事實 ▸... » read more