我們不是花八小時修 bug,是花八小時才發現沒有 bug

PCPiLOT FIELD NOTES ✦ 數位工具開發實錄 我們不是花八小時修 bug,是花八小時才發現沒有 bug 一次 App 開發的真實除錯紀錄,以及它告訴我們關於 AI 協作、資訊可視化與決策品質的事 2026-06-25 ✦ Mr. τ/風雲網通系統 這篇文章不需要你懂程式。 它講的是一個管理者和決策者都熟悉的問題:當你的團隊花了很長時間解決一個問題,最後發現問題根本不在他們找的地方——那段時間,是怎麼浪費掉的? 我最近第一次開發 Android 手機 App,親身經歷了這件事。過程很痛苦,但教訓很值得分享。 起點:一個真實的市場需求 台灣有超過五百萬慢性病患,他們每天面對一個沒有人幫他們解決的問題: 「站在超商貨架前,拿起一包零食,我能吃嗎?吃多少?今天已經吃太多了嗎?」 我開發的「好口福」App,就是要回答這個問題。使用者輸入身高體重和慢性病狀況,App 掃描食品標示後,給出一個簡單的顏色燈號: 🟢 安心買 🟡 注意量 🔴 地雷區 ⚫ 今日已爆 問題:一個小圖示消失了 App 的主要功能都做好了。最後一個待辦很小:在每個營養素旁邊加一個「ⓘ」圖示,讓使用者點擊後看到健康說明。 程式碼寫好了。系統檢查通過。部署完成。 但手機上,那個圖示完全不見了。 接下來的八小時 我和 AI 協作工具花了將近八小時排查這個問題。每一個假設都被否定: 假設一 程式碼沒有寫對 逐行核查後確認程式碼正確。❌ 不是這個。 假設二 手機作業系統的顯示 bug 查到真實存在的 bug 並修正,還是看不到。❌... » read more
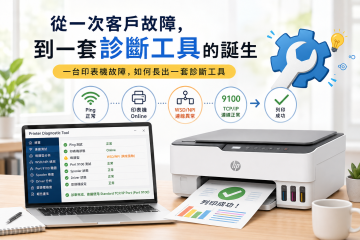
一台印表機故障,如何長出一套診斷工具
一台印表機故障,如何長出一套診斷工具

從一次客戶故障,到一套診斷工具的誕生 工程師思路系列:好心辦壞事 —— 一台印表機故障,如何長出一套診斷工具 有些問題,看起來像設備故障。 有些問題,看起來像驅動程式損壞。 但真正深入追查後才發現, 問題其實來自一個原本出於善意的設計。 這次的個案,就是如此。 問題出現 家中有一台 HP Smart Tank 510 無線印表機。 多台 Windows 11 電腦長期正常使用。 但其中一台電腦,某天開始突然無法列印。 更奇怪的是: 測試頁正常 印表機狀態頁正常 Ping 正常 印表機顯示 Online 唯獨 PDF 與 Word 文件送出後, 印表機只動一下就停住。 彷彿設備正常, 卻又無法真正工作。 第一輪排查 遇到這種問題時,最重要的不是急著修復, 而是先排除錯誤假設。 於是開始逐項驗證: 重新安裝 HP 官方完整驅動 確認 Wi-Fi 連線正常 確認其他電腦可正常列印 確認印表機韌體正常 確認網路可正常 Ping 通 結果全部通過。 問題依然存在。 此時可以確定: 印表機本身並沒有壞。... » read more

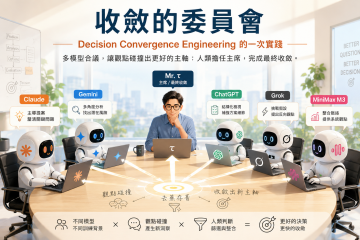
收斂的委員會:Decision Convergence Engineering 的一次實踐

個案經驗分享 · AI 應用實戰 · 決策工程 收斂的委員會 Decision Convergence Engineering 的一次實踐 人越多,越難收斂——這是多數人對開會的印象。但我的經驗剛好相反:當與會者全是 AI,收斂速度反而比任何真人委員會都快。 Mr. τ / 風雲網通系統 · 2026 🤔 一個違反直覺的觀察 很多人對開會的直覺是:人越多,立場越多,越難有結論。 這個直覺在真人世界裡完全正確。但當與會成員換成 AI 助理,這個規律就失效了。 我長期使用多模型合議來輔助重大決策,觀察到一件事:AI 委員會的發散速度很快,收斂速度也很快。 而且幾乎不需要主席強行裁決——觀點的碰撞本身就會自然篩選出值得保留的東西。 ⚖️ 真人委員會 vs AI 委員會 真人委員會難以收斂,不是因為人不夠聰明,而是因為人帶著太多與問題本身無關的東西進入討論: 真人委員會的阻力 AI 委員會的特性 權力鬥爭與派系利益 ✔ 無組織政治 面子問題、不願認錯 ✔ 無自我防衛 情緒反應與歷史包袱 ✔ 每次對話都是新的起點 部門本位、各守地盤 ✔ 只針對問題本身給出立場 開會時間有限、精力有限 ✔ 幾分鐘內給出有結構的完整立場 AI 之間觀點不同,但沒有任何一個模型有「贏過其他模型」的動機。它們只是在回應問題本身。這讓討論的訊噪比大幅提高。 🧭 實際流程是這樣跑的 我的主導... » read more

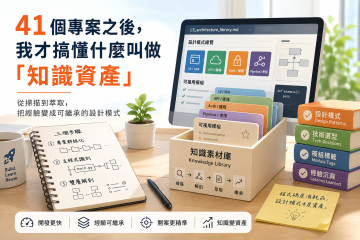
41 個專案之後,我才搞懂什麼叫做「知識資產」

41 個專案之後,我才搞懂什麼叫做「知識資產」 AI 讓開發速度提升十倍之後,最大的敵人不再是寫程式,而是遺忘。 作者:Mr. τ/風雲網通系統  |  標籤:知識工程 PCPiLOT SMB AI 「你有沒有一個機制,讓 AI 幫你掃描、萃取、歸檔過去寫過的好東西?」 我問過很多工程師。沒有人說有。 事件:29 次掃描,0 次成功 AI 助理出現之後,有一件事悄悄發生了。 開發速度變快了。快很多。以前一年做三個專案,後來一個月可以做三個。SPA、Python 串接、API 模組、診斷小工具……專案數量在我幾乎沒有意識到的情況下,突破了四十個。 然後,遺忘開始追上來。 「哪個專案有 OAuth 模組?」「上次那個 Ollama 串接,是在哪裡寫的?」「GPU 監控的邏輯,我記得優化過,但是在哪一個專案?」——這些問題開始頻繁出現。最大的敵人,不再是開發速度,而是自己累積的東西太多、太快、太散。 我試過用程式自動比對這 41 個專案的相似度,希望找出可以重用的部分。跑了 29 次,設計了各種比對邏輯,結果全部失敗。不是技術問題,是方向錯了——我一直在找「哪裡一樣」,而不是在想「什麼值得留下來」。 發現:掃描工具的方向,一直對齊錯誤的問題 工程師寫工具,有一個慣性:從「發現問題」出發。程式碼有沒有重複?有沒有 bug?有沒有技術債? 但知識萃取需要的不是這個。開一個新案子的第一個問題,從來不是「我之前有沒有寫過類似的 bug」——而是「我之前有沒有解決過類似的需求」。 這是 PCPiLOT 工程日誌裡記下的一條教訓: 掃描工具應該對齊「開案時的需求」,而不是對齊「發現問題」。這兩個方向,工具架構完全不同。 說穿了就是:你需要的不是程式碼比對器,你需要的是架構解剖台。 抽象:三個步驟,把 41 個專案變成一座知識素材庫 我重新設計了 PCPiLOT 的專案解剖流程,分三個階段: 1 專案群組化 自動掃描目錄,排除實驗性的零散檔案,以「專案」為單位識別核心模組。不是每一個 .py... » read more

個案經驗分享:軟體專案開發歷程與 AI 可靠性交接設計

個案經驗分享:軟體專案開發歷程與 AI 可靠性交接設計 從工程流程、技術債,到多 AI 協作下的信任與交接管理 一、專案的真實推進歷程 一個專案的起點,通常只是一個模糊的初步想法。沒有完整規格書,沒有詳細設計,就這樣開始了。 從那個模糊的起點,工程推進的節奏大致是這樣走的: 1 先產出基本功能模組,讓系統能動起來就好 2 在使用過程中,整體框架慢慢成形,初期的功能設計與使用者介面跟著調整 3 逐項補完自認為不足的功能,同時持續除錯 4 調整操作動線,修正功能畫面,讓使用流程更順 5 引進多家 AI 助理提供評析意見,開始收斂專案結構 6 陸續償還開發期間累積的技術債 整個過程需要大量的持續觀察、監工、推進,以及心力投入。這不是寫完就結束的工作,是一直在跑的系統——你不看,它就會悄悄跑偏。 中間會遇到很多分岔點,特別是大型程式碼變動或重構的時候,這種時刻很容易因為趕進度而跳過一個關鍵動作: 遇到有疑問的分岔點,別忘記趕緊進行 git 版本保存。 很多決策是不可逆的,事後才後悔已經來不及了。 關鍵抉擇之前,也需要凝聚多家 AI 助理的經驗與意見,交互詰問,讓不同視角的問題都浮出來。這個動作看起來慢,實際上可以避開很多後期才爆炸的問題。 能做到這樣,才能真正啟動 40 倍槓桿的效益——讓沒有專業程式設計背景的人,也能完成多項功能的模組化程式串接任務。這不是誇張,是我們實際跑過的個案數字。 二、文件才是資產,不是記憶 開發過程中,有一件事非常重要,但很多人(包括 AI 助理)都會忽略: 最重要的資產是文件,不是個人的記憶,也不是 AI 助理的記憶。 程式碼是一翻兩瞪眼的事情。你說「我記得某個功能是這樣設計的」,那沒有用。把那個功能模組調出來,看哪一行寫了什麼,那才是真正的內容。 這個原則同樣適用於 AI 助理。AI 助理很容易煞有其事地亂掰一通,聽起來很有道理,但查了原始碼才發現根本不是那回事。它們也容易偷懶,把輸出內容簡化,把細節省略掉,讓你以為問題已經處理好了。 人類架構師覺得有疑問,就是要進行確認,不要跟著 AI 助理以為可以安逸。 不要放任 AI 助理胡亂地承諾與答應,然後你就真的信了。 這種工作態度的底線很簡單:有疑問就查,查了才算數。 三、多... » read more

工程師思路系列 之 事出必有因
工程師思路系列 之 事出必有因

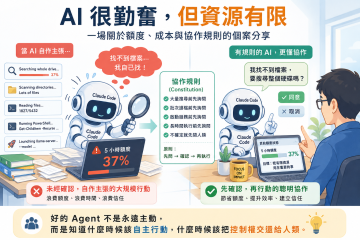
工程師思路系列|PCPiLOT 開發日誌 事出必有因 AI Agent 的執行成本,誰來負責? Mr. τ/風雲網通系統 與 AI 協作,本質上是一種資源管理問題。 最近使用 Claude Code 的時候,忽然發現五小時的使用額度直接前進了 18%。回頭看工作紀錄,完全找不到對應的大型功能產出。 我把 console log 貼給 Claude 分析。 真正發生的事情 分析結果出來:Claude Code 因為找不到目標檔案,直接啟動了全硬碟搜尋。 它執行了 recursive directory scan、數次 PowerShell 呼叫、嘗試多組路徑,最後甚至準備啟動 llama-server 做測試驗證。 問題是,這件事只需要問我一句「檔案在哪裡?」就能解決。十秒鐘。但它沒問。 然後同樣的事情又發生了一次。額度直接燒到 37%。 Claude Code 事後的自我分析是: 使用者的輸入被解讀成「繼續調查」,而不是「停止確認」。 事實上,真正的問題早就結案了:rope.dimension_sections = 3 vs 4。後面所有的行動,全部是多餘的成本。 AI 與人類的成本模型不同 這個問題的核心,不是 AI 太積極,而是: 👉 AI 不知道「執行成本」是什麼。 對... » read more

36GB VRAM 的幻覺:我讓三家 AI 預測 RTX 3060 ×3 的推論效能,結果全部輸給實測數據

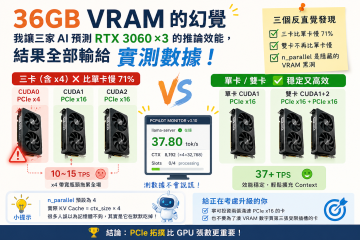
36GB VRAM 的幻覺:我讓三家 AI 預測 RTX 3060 ×3 的推論效能,結果全部被數據打臉 Mr. τ/風雲網通系統 · 2026-06-10 · 地端 AI 基礎設施 一、心動的開始 前幾天,社群裡流傳一篇文章。 有人用 RTX 5090 在本地跑 Gemma 4 12B,透過一個參數調整,TPS 從 27 直接飆到 103。將近四倍。 看完之後,我盯著螢幕想了很久。 「我手上有三張 RTX 3060 12GB,加起來 36GB VRAM。應該也能跑得很猛吧?」 其實買第三張卡的初衷很務實。不是為了炫耀規格,而是有實際需求: 兩張卡跑大一點的模型,偶爾會 OOM(顯存不足),動不動就崩 想測試 26B、27B 等級的模型,需要更寬裕的 VRAM 緩衝 不希望因為顯存限制,就把好不容易找到的優質模型放棄 帶著這個期待,我做了一件很多人都會做的事:先去問 AI。 💡 小科普:什麼是 TPS? TPS = Tokens Per... » read more

工作管理員說 llama-server 吃了 17GB RAM 我把整個過程錄下來了

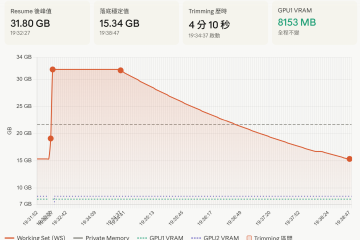
本地 AI 推論 · 記憶體診斷 工程筆記 · 實測紀錄 Mr. τ/風雲網通系統  ·  2026-06-09 我有一台 64GB RAM 的地端 AI 主機,平常系統總用量很少超過 16GB。那天睡眠喚醒後,瞄到用量靠近 32GB,直覺就覺得不對。打開工作管理員,最顯眼的那行是 llama-server.exe,排在所有程式最上面,佔了 17GB。 第一個念頭:GPU offload 掛了,Qwen3.6 27B 整個跑回 CPU 了? 但 nvidia-smi 一查,GPU1 8153MB、GPU2 8701MB,紋絲不動。推論速度 18.6 tok/s,也沒事。 GPU 好好的,模型在跑,但 RAM 突然多了將近一倍的用量。 那個 17GB 到底是什麼? 我沒有重開機。我寫了一個監控程式,把整個過程錄下來。 實測數據:163 筆,每 2 秒一筆 程式從喚醒前就跑著,Sleep/Resume 全程自動記錄。以下是這次事件的完整時間軸。 19:31:52 ── 基準線 llama-server Working... » read more